AI News
Google 发布 EmbeddingGemma 2:基于 Gemma 4 的开源多模态嵌入模型
EmbeddingGemma 2: The Developer Guide
Google 发布基于 Gemma 4 的开源嵌入模型 EmbeddingGemma 2,采用 Apache 2.0 许可,将文本、代码、图像、视频和音频映射到统一的 768 维向量空间,参数量从 270M(文本/代码)到 740M(全模态)按需加载。
原文给出了各模态参数配置、维度压缩的具体存储数字和选型建议,开发者可据此规划本地多模态检索方案。
另有 5 家信源报道正文 · AI 翻译中文原文2026年10月6日
现代搜索和检索增强生成(RAG)应用日益需要跨多种内容类型工作,从技术文档和源代码到图像、视频片段和音频录音。挑战在于找到既能提供强大检索准确性,又能在所有这些格式上保持低延迟,且无需庞大计算基础设施来运行和索引的模型。
EmbeddingGemma 2 旨在提供一个以 Apache 2.0 许可证发布的单一、紧凑的开放模型,为其规模提供卓越的多模态性能。基于 Gemma 4,这个低于 1B 的模型将文本、代码、图像、视频和音频映射到一个统一的 768 维空间。其模块化架构让你只加载所需内容,从用于文本和代码的 270M 参数扩展到用于所有模态的 740M 参数。
关键能力包括:
EmbeddingGemma 2 用投影到共享 768 维空间的模块化编码器取代了链式模型:
尽管每种模态由专门的编码器处理,但所有输入都通过共享主干处理,其生成的嵌入占据相同的维度空间:
抱歉,你的浏览器不支持播放此视频
我们用 270M 纯文本设置嵌入了 Hugging Face transformers 代码库。然后,这些嵌入被用于通过使用智能体(Gemma 4 26B A4B 搭配 Pi 智能体框架)将查询与代码库的相似度进行匹配,从而高效地搜索这个大型代码库。
你可以使用 sentence-transformers 库(v6.1.0 或更高版本)在文本、代码、图像、视频和音频上运行 EmbeddingGemma 2:
pip install -U sentence-transformers[image,audio,video] transformers Shell
完整模型可嵌入文本、代码、图像、视频和音频:
from sentence_transformers import SentenceTransformer # Full model: all modalities (740M parameters) MODEL_ID = "google/embeddinggemma-2" model = SentenceTransformer(MODEL_ID) Python
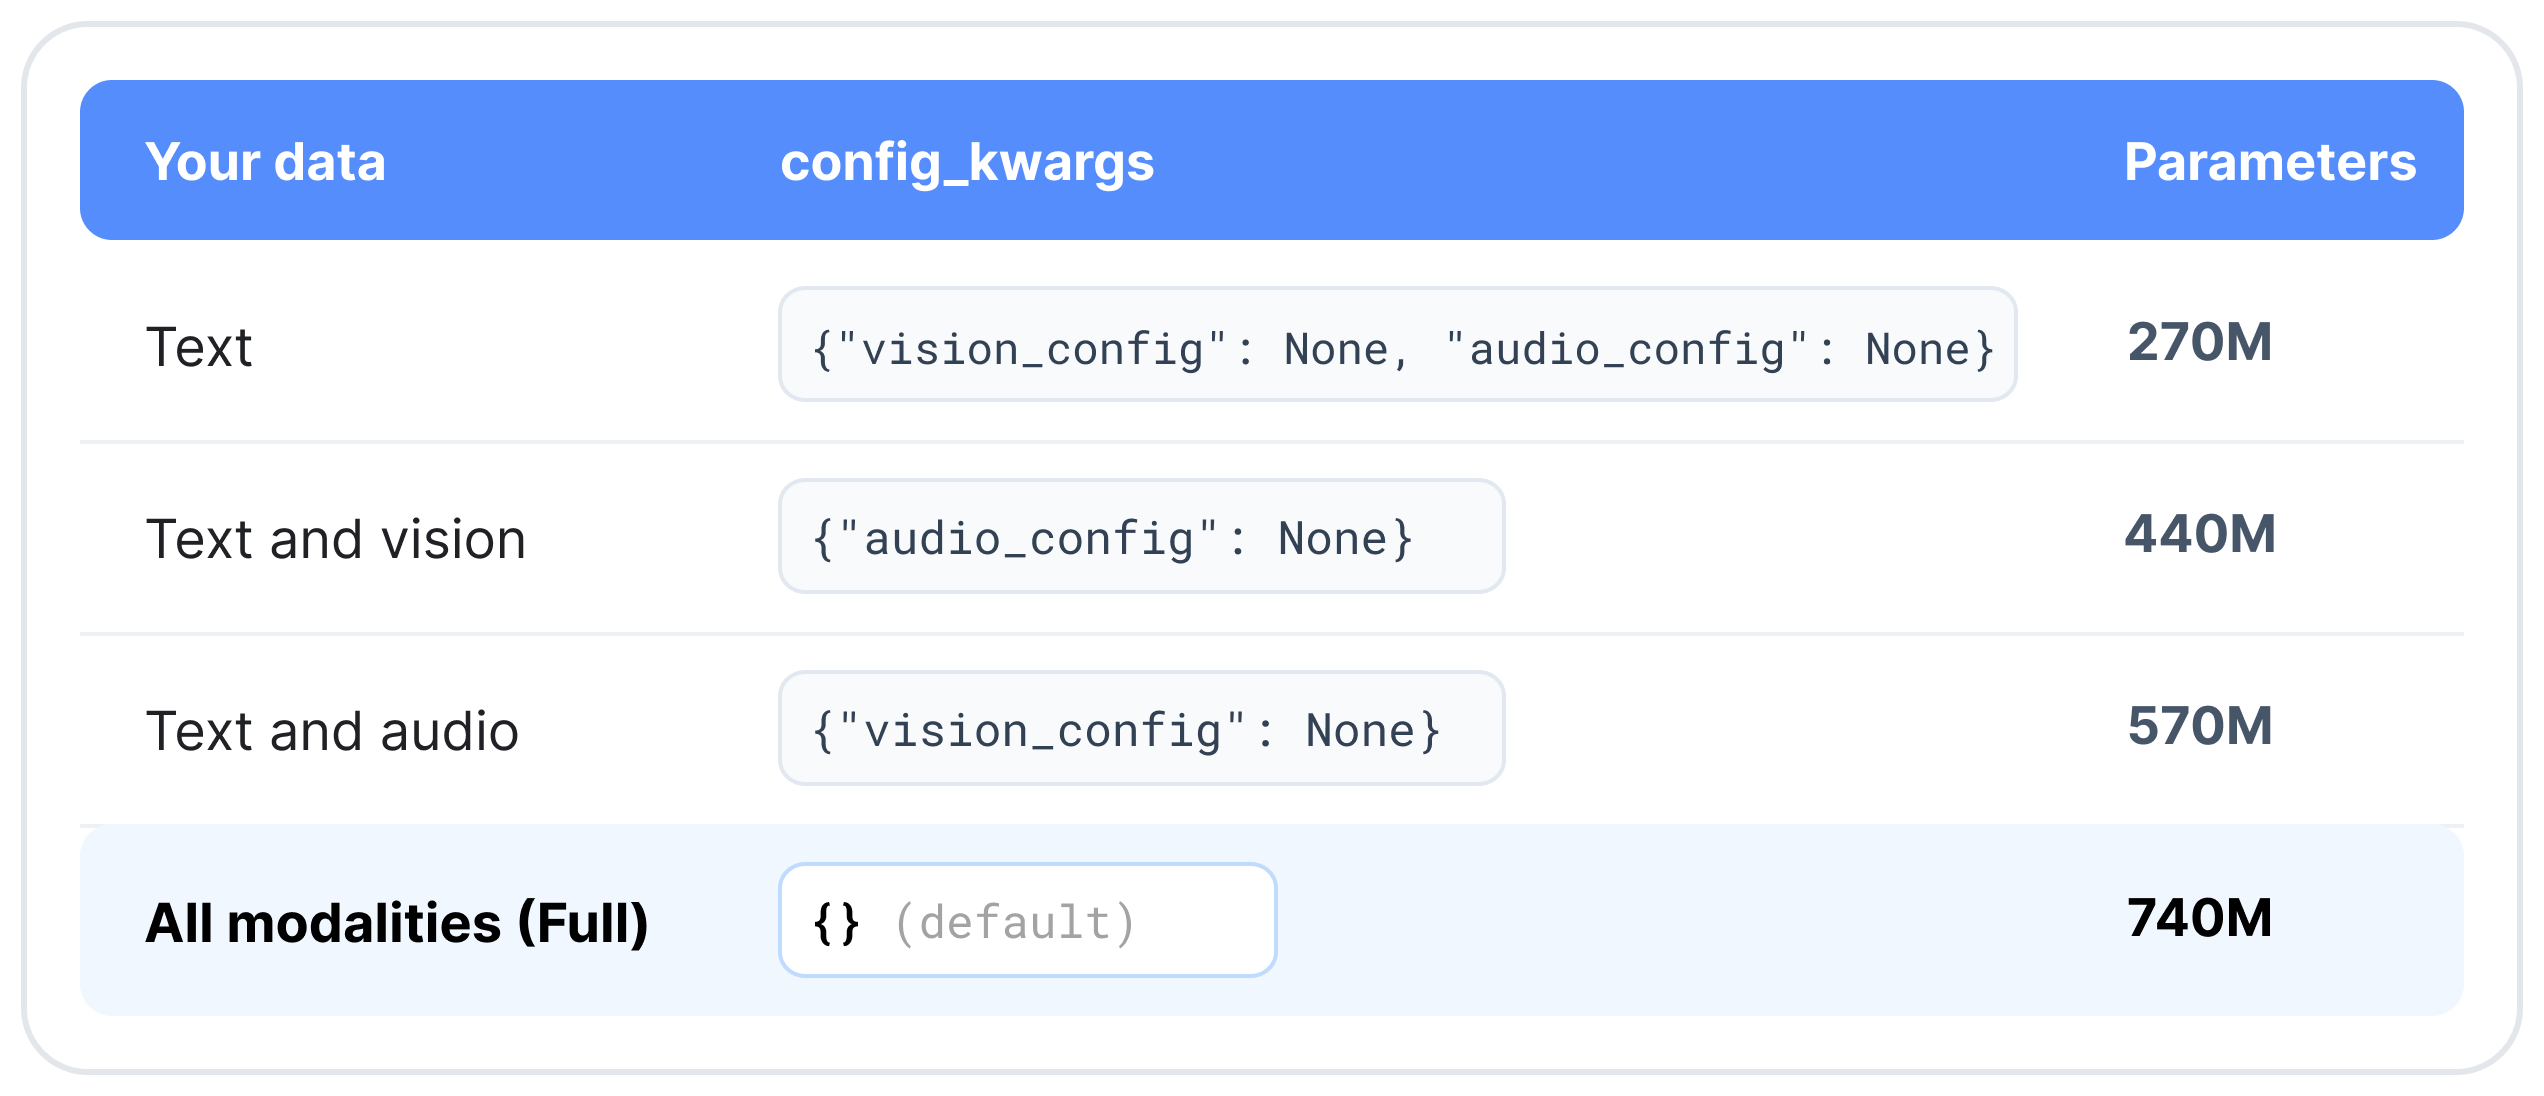
为尽量减少内存占用,你可以在加载时将 `vision_config` 或 `audio_config` 设为 None(在 config_kwargs 中),从而省略未使用的模态编码器。被禁用的编码器永远不会加载到内存中,因此节省的内存既适用于权重,也适用于峰值分配:
# Text only (270M parameters) text_only_model = SentenceTransformer( MODEL_ID, config_kwargs={"vision_config": None, "audio_config": None}, ) # Text, images, and video (440M parameters) text_image_model = SentenceTransformer( MODEL_ID, config_kwargs={"audio_config": None}, ) # Text and audio (570M parameters) text_audio_model = SentenceTransformer( MODEL_ID, config_kwargs={"vision_config": None}, ) Python
EmbeddingGemma 2 在训练时使用了简短的任务指令,以引导表示面向特定任务。在 encode() 中设置 prompt_name,即可自动添加:
对于检索,请使用不同的提示分别编码查询和文档:
query = "What causes the northern lights?" document = "The northern lights are caused by charged particles from the sun.." # truncated # Embed using `prompt_name` query_emb = model.encode(query, prompt_name="SearchQuery") doc_emb = model.encode(document, prompt_name="Document") print(model.similarity(query_emb, doc_emb)) Python
将媒体作为以模态为键的字典传入,无需提示。要同时嵌入文本和媒体,请用 <|image|>、<|video|> 或 <|audio|> 标记每一项的位置:
# Cross-modal search: one text query against a photo and a sound recording image_emb = model.encode({"image": "sunset_beach.jpg"}) audio_emb = model.encode({"audio": "ocean_waves.wav"}) query_emb = model.encode("ocean waves at sunset", prompt_name="SearchQuery") print(model.similarity(query_emb, image_emb)) print(model.similarity(query_emb, audio_emb)) # Interleaved: one embedding for a product listing with text, photo, and video listing_emb = model.encode({ "text": "Waterproof trail shoe. <|image|> Grip test on wet rock: <|video|>", "image": "trail_shoe.jpg", "video": "grip_test.mp4", }) query_emb = model.encode("waterproof trail shoes", prompt_name="SearchQuery") print(model.similarity(query_emb, listing_emb)) Python
尽管来自不同的模态,EmbeddingGemma 2 生成的嵌入仍占据相同的维度空间,可以按其语义相似度进行比较。
将 truncate_dim(512、256 或 128)与 normalize_embeddings=True 一起传入,即可获得更短的、单位长度的向量。查询和文档必须使用相同的维度:
# Truncate the query query_emb = model.encode( query, prompt_name="SearchQuery", truncate_dim=256, normalize_embeddings=True, ) Python
若要在每次调用中使用同一维度,可在加载时设置:SentenceTransformer(MODEL_ID, truncate_dim=256)。例如,在 bfloat16 精度下,存储一百万个 768 维向量大约需要 1.5 GB 内存,而将它们截断到 128 维则只需 250 MB。6 倍的缩减让你能在相同的内存预算下存储六倍数量的嵌入,从而更容易在内存中或设备端容纳大型索引。
在 sentence-transformers 中,四种编码器设置都从同一个检查点加载,因此它们共享同一个向量空间:使用 270M 纯文本设置嵌入的查询,可以直接与使用完整模型嵌入的文档进行匹配。
一般原则是,只加载你的数据所需的编码器,并且仅在存储或搜索速度需要时才截断维度。
如果你从纯文本索引开始,之后又添加图像或音频嵌入,只需重新加载模型并启用额外的编码器即可。你已经计算过的嵌入无需重新计算。
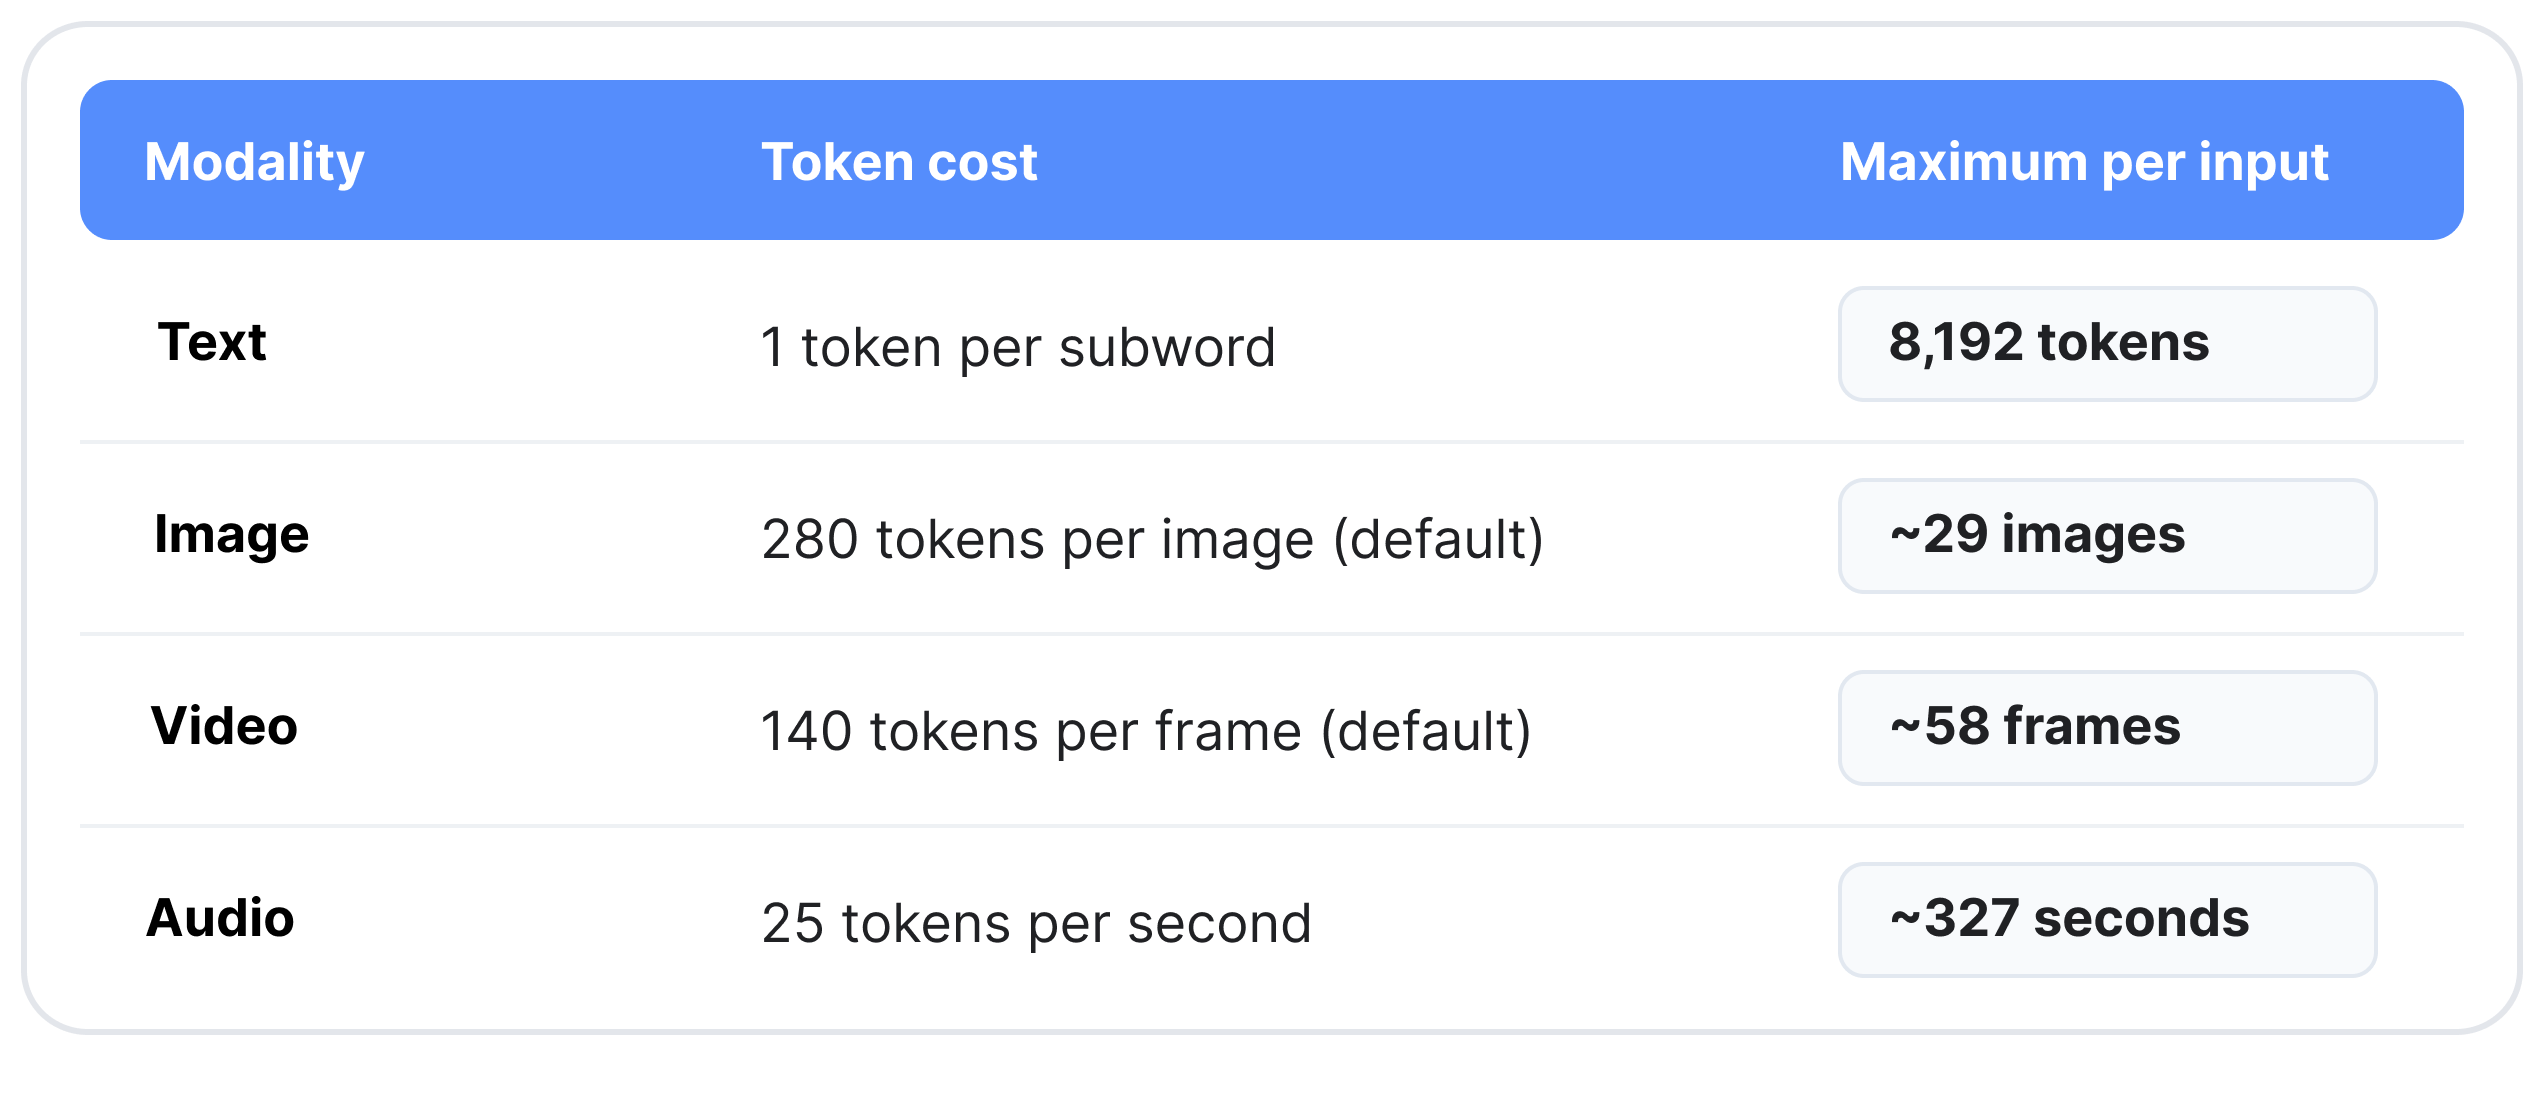
所有模态共享 8,192 个 token 的上下文窗口,且速率固定:
最大值假设为单一模态且不含文本。将媒体以文件路径(视频为 MP4)、URL(图像和音频)或内存中的 PIL 图像、数组和张量形式传入。视频默认按每秒 1 帧采样,音频应为 16 kHz 单声道。
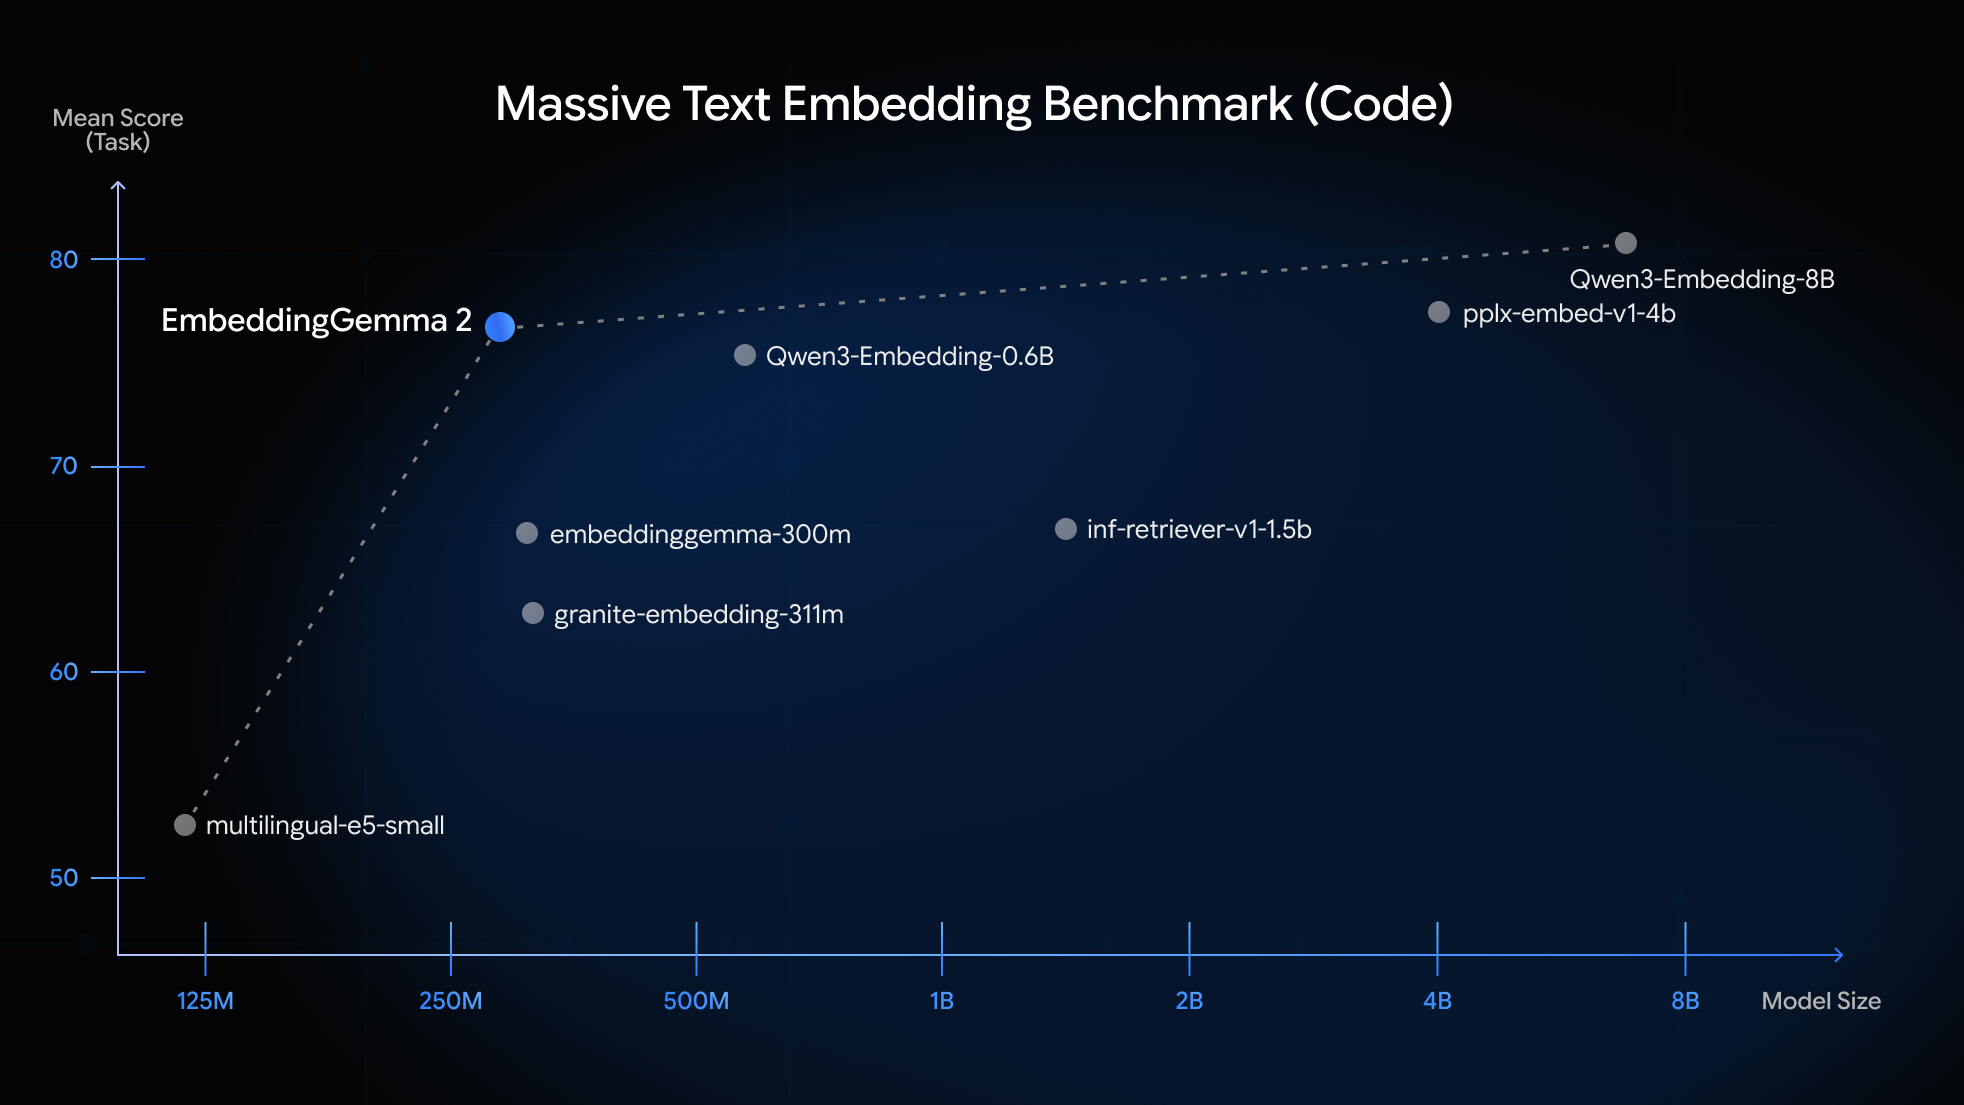
EmbeddingGemma 2 在 MTEB (Code) 上比 EmbeddingGemma 1 高出 14%,新增图像、视频和音频检索,同时保持 EmbeddingGemma 1 的多语言文本准确率
准备好探索多模态嵌入了吗?查看以下资源以了解更多:
来源:Google Developers Blog · developers.googleblog.com
配图