AI News
蚂蚁 inclusionAI 开源 Ming-3.0-tts 语音合成模型
inclusionAI/Ming-3.0-tts
蚂蚁 inclusionAI 在 GitHub 发布 Ming-3.0-tts,包含 0.5b dense 和基于 Ling V3 的 tiny(7.9B 总参数、1.3B 激活)两个语音生成模型,MIT 协议开源,权重可在 Hugging Face 和 ModelScope 下载。
官方仓库给出两版模型的榜单名次、完整任务列表和部署细节,读者可据此评估其在多语言与副语言控制上的实际可用性。
另外 3 家也报道了正文 · AI 翻译中文原文支持自由形式与副语言控制的多语言语音合成。
🤗 Hugging Face| 🤖 ModelScope | 📑 博客与演示 | 💬 DingTalk(钉钉)
Ming-3.0-tts 提供两个语音生成模型:0.5b,一个稠密模型,以及 tiny,一个基于 Ling V3 构建的 MoE 模型(总参数 7.9B · 激活参数 1.3B)。
在独立的 Artificial Analysis 文本转语音排行榜上(2026 年 10 月),Ming-3.0-tts 在受控语音类别中位列开源权重模型第 1 名,在发音稳健性类别中位列总榜第 1 名,并在提供方语音类别中位列开源权重模型第 3 名。排名会随着新模型的加入而变化。
在发音稳健性类别中,Ming-3.0-tts 还在扩展缩写(文本规范化,96.5%)和保留精确序列(序列保真度,90.6%)两项上位列第 1 名。
各项能力使用独立的任务模式,而非任意组合。支持的输入请参阅 Cookbook,基准测试请参阅 Performance,音频示例请参阅 博客与演示。
tts11_under10mb.mp4
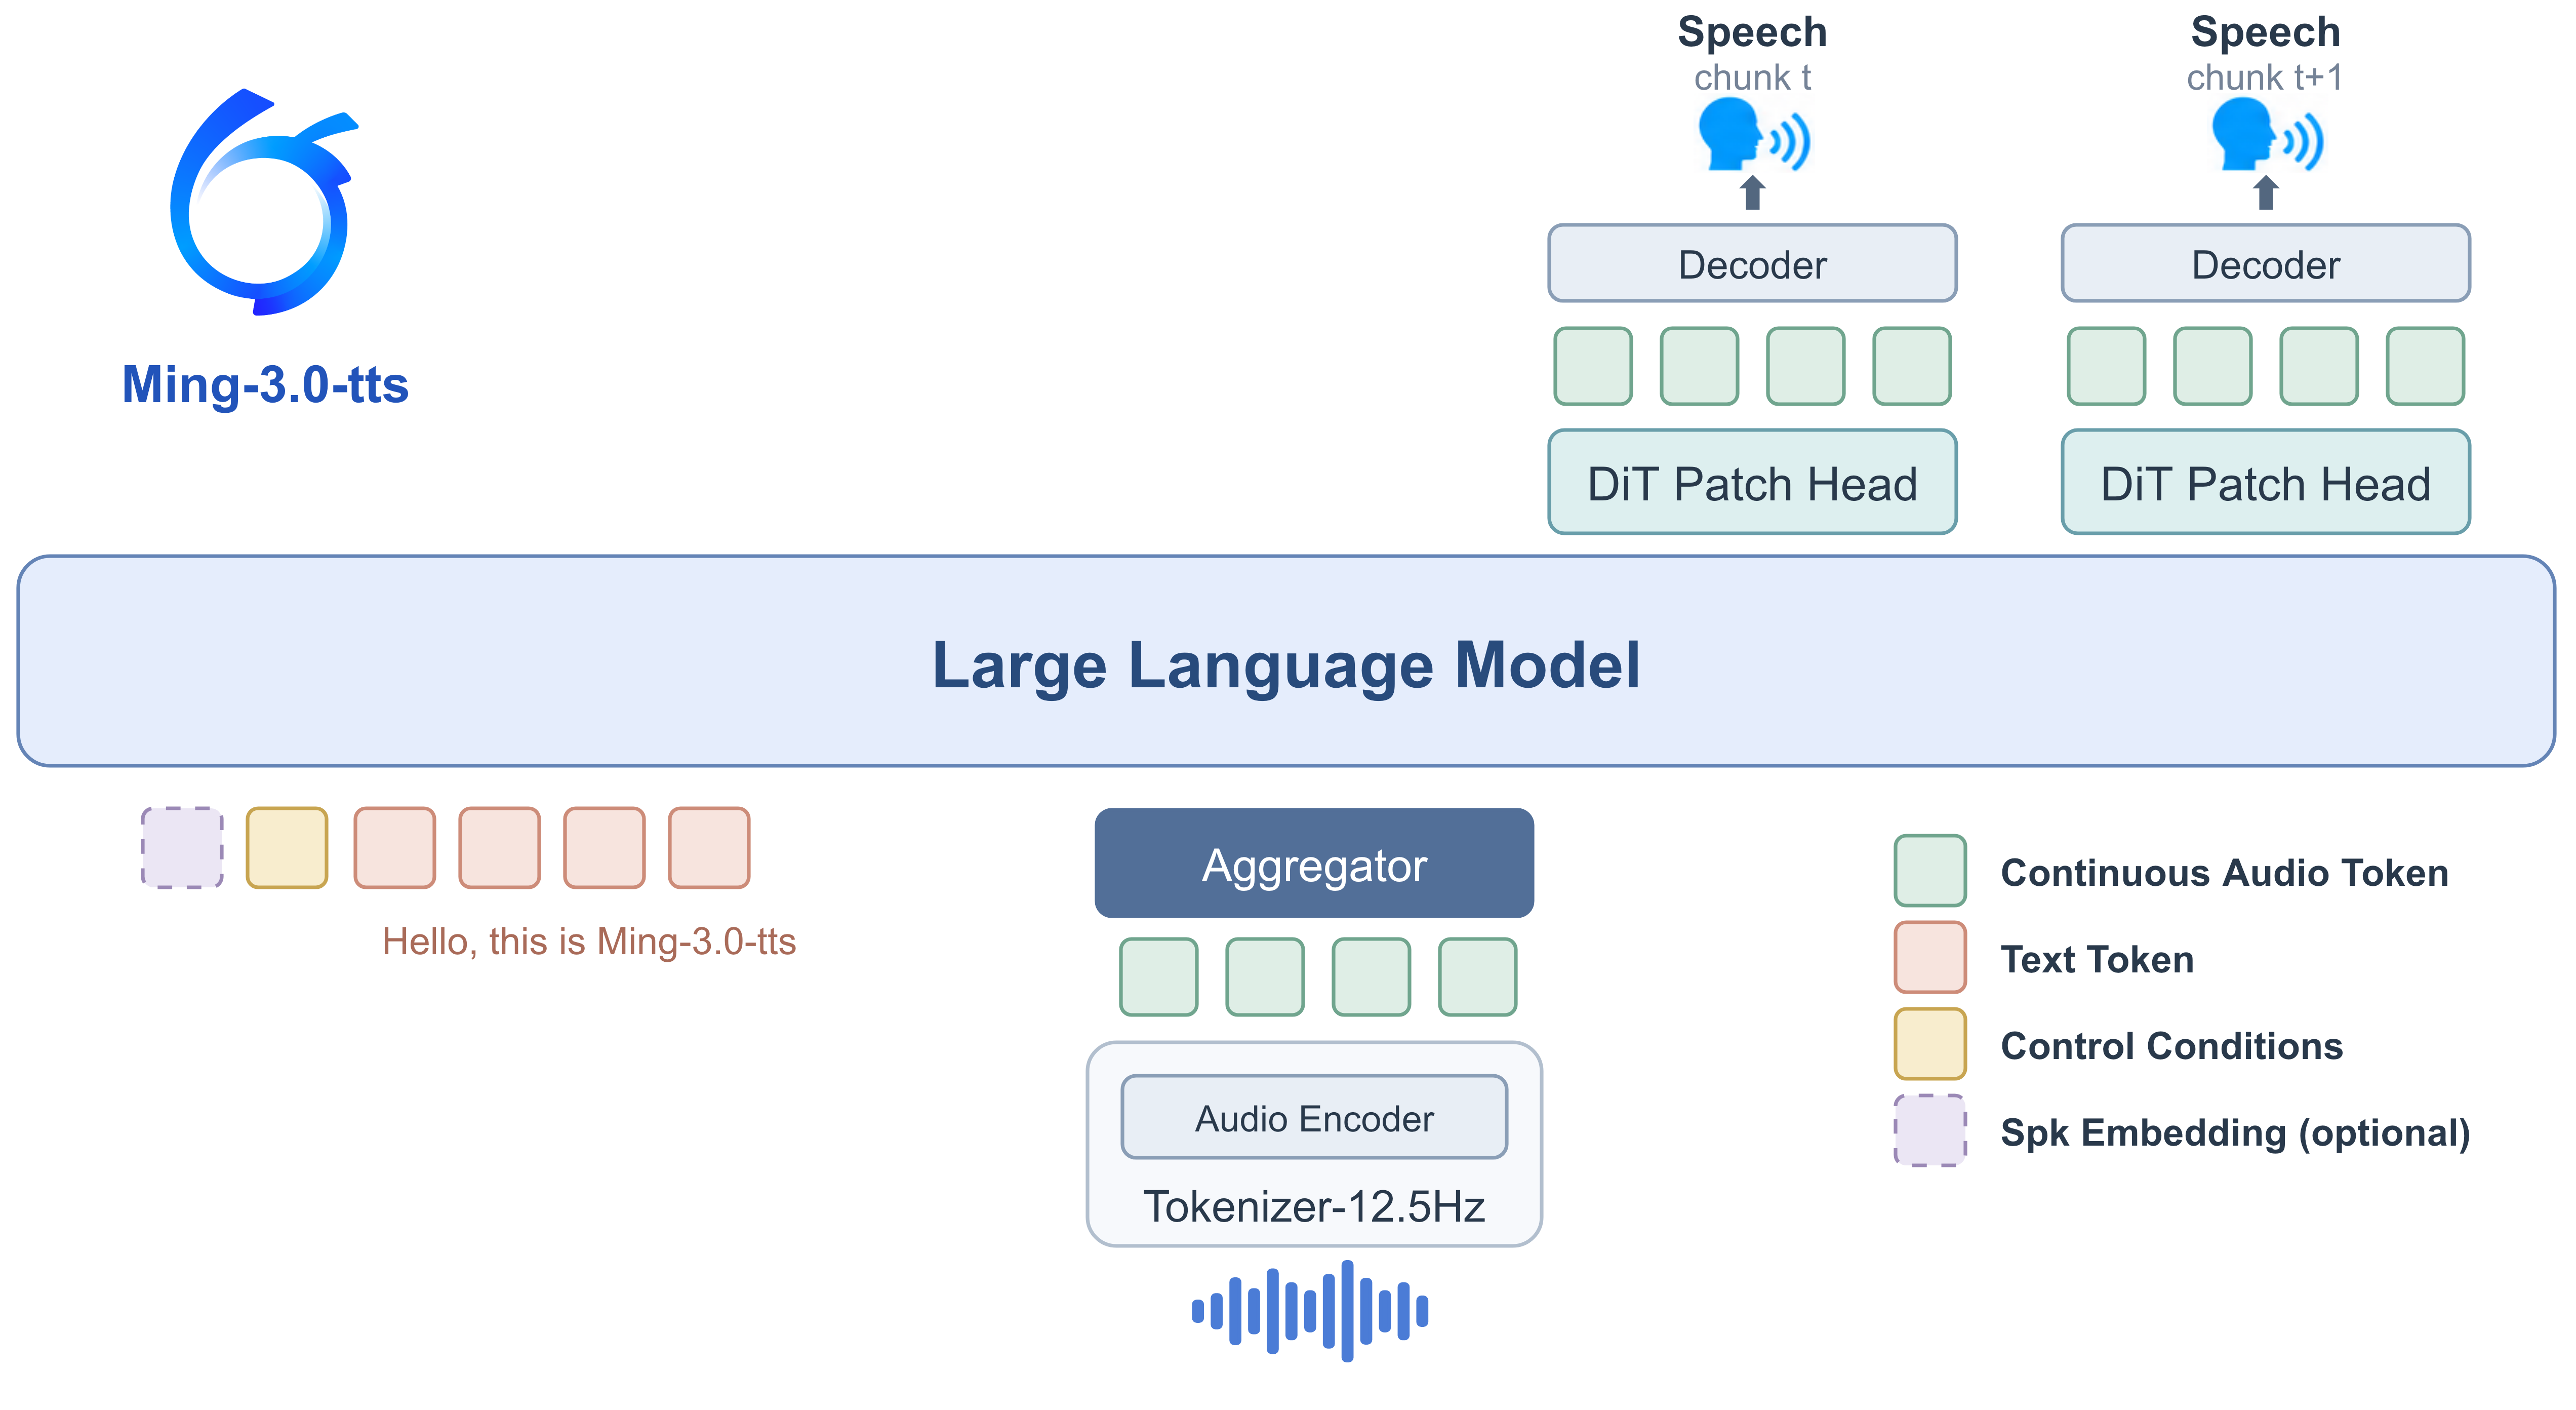
文本和任务特定的控制 token 作为条件输入到一个语言模型,该模型带有 DiT patch head 和音频分词器。两个模型共享这一生成框架。
每个发布检查点都打包了 backbone、DiT head、音频 tokenizer、说话人编码器和文本 tokenizer。0.5b 发布版的目录结构如下所示;tiny 使用分片权重,配合 model.safetensors.index.json。
Ming-3.0-tts-0.5b/ ├── config.json # model_type: dense, auto_map -> BailingMMConfig ├── configuration.json # ModelScope task descriptor ├── model.safetensors # backbone + audio VAE + DiT head + aggregator ├── campplus.onnx # speaker embedding extractor ├── tokenizer.json # plus vocab.json / merges.txt / added_tokens.json ├── tokenizer_config.json # special_tokens_map.json / chat_template.jinja └── README.md 快速开始 🚀安装git clone https://github.com/inclusionAI/Ming-3.0-tts.git cd Ming-3.0-tts pip install -r requirements.txt # Ming-3.0-tts-0.5b或者构建 0.5b Docker 镜像(torch 2.6、CUDA 12.4、transformers==4.46.3):
docker build -f docker/Dockerfile -t ming-tts .0.5b 环境已在 NVIDIA H800-80GB 和 H20-96G 上测试过。对于 0.5b,flash-attn 是可选的;推理会回退到 PyTorch SDPA。
Tiny 使用单独的参考推理环境:Python 3.10.15、PyTorch 和 torchaudio 2.7.1+cu118(CUDA 11.8 wheels),以及 transformers==4.46.3。请在专用环境中从 requirements-tiny.txt 安装固定版本的依赖,因为其他依赖版本与 0.5b 不同。我们建议使用 NVIDIA H800 进行推理。
conda create -n ming-tiny python=3.10.15 -y && conda activate ming-tiny pip install -r requirements-tiny.txt模型下载pip install "huggingface_hub[cli]" hf download inclusionAI/Ming-3.0-tts-0.5b --local-dir Ming-3.0-tts-0.5b在中国大陆,ModelScope 通常更快:
pip install modelscope modelscope download --model inclusionAI/Ming-3.0-tts-0.5b --local_dir Ming-3.0-tts-0.5b将 0.5b 替换为 tiny 即可获取另一个变体。
数字、日期、单位和符号通过 FST 语法进行规范化,这需要 pynini。它没有通用 wheel:
conda install -c conda-forge pynini==2.1.6 # or: pip install pynini==2.1.6它是延迟加载的;传入 --no_text_normalization 可跳过它。
python infer.py \ --model_path inclusionAI/Ming-3.0-tts-0.5b \ --task TTS \ --language_id Chinese \ --text "傍晚的风从山口吹过来,远处的云慢慢染成了金色。" \ --prompt_wav_path data/voice_presets/voice_audio/lingguang.wav \ --prompt_text "诶,你今天有空吗?我们能不能聊聊这件事啊?" \ --use_spk_emb \ --output output/tts.wav或者从 Python 中:
from ming_tts import MingTTS model = MingTTS("inclusionAI/Ming-3.0-tts-0.5b") model.synthesize( task="TTS", language_id="Chinese", # English for English text text="傍晚的风从山口吹过来,远处的云慢慢染成了金色。", prompt_wav_path="data/voice_presets/voice_audio/lingguang.wav", prompt_text="诶,你今天有空吗?我们能不能聊聊这件事啊?", use_spk_emb=True, output_path="output/tts.wav", )Ming-3.0-tts-tiny每个任务在 examples/one_click/ 中都有一个单行脚本;诸如 MODEL、TEXT 和 OUT 这样的变量可以从环境变量中覆盖:
bash examples/one_click/run_seed.sh MODEL=/path/to/Ming-3.0-tts-tiny OUT=outputs/yue.wav bash examples/one_click/run_dialect.sh从 Python 中调用同样如此。加载时会配置发布版运行时(bf16、可移植 MoE 循环、fp32 循环状态)并对照检查检查点;generate() 默认为 cfg_scale=2.0、temperature=0、flow_steps=10、sigma=0.25,随机种子为 1234(podcast 为 1235):
from ming_tiny import MingTinyTTS tts = MingTinyTTS.from_pretrained("inclusionAI/Ming-3.0-tts-tiny", device="cuda:0") tts.generate( task="seed", text="傍晚的风从山口吹过来,远处的云慢慢染成了金色。", prompt_wav="data/voice_presets/voice_audio/lingguang.wav", prompt_text="诶,你今天有空吗?我们能不能聊聊这件事啊?", target_language="Chinese", # English for English text output_path="outputs/seed.wav", ) tts.generate( task="podcast", text="speaker_1: 你最近是不是又去那家面馆了?\nspeaker_2: 对啊,排了半个小时的队,不过真的值得。", prompt_wav=["data/voice_presets/voice_audio/lingguang.wav", "data/voice_presets/voice_audio/db30.wav"], prompt_text=["诶,你今天有空吗?我们能不能聊聊这件事啊?", "感谢你的认可。"], output_path="outputs/podcast.wav", )每次调用选择一个任务,并接受下面列出的输入:
python infer_tiny.py --help 为命令行列出了相同的参数;对于播客,重复 --prompt_wav 和 --prompt_text。
在不加载权重的情况下检查检查点和 tokenizer:
python tools/preflight.py --model_path /path/to/Ming-3.0-tts-0.5b python tools/preflight_tiny.py --model_path /path/to/Ming-3.0-tts-tinyCookbook按照一行语音的生成顺序排列:谁在说话、如何说、超越文字的内容,以及在哪里听到。每个示例对应一个任务;来自其他任务的控制项会被拒绝。文本和控制项与 演示页面 上的一致,因此你可以与在那里听到的内容进行对比。0.5b API;完整取值列表见 English / 简体中文,每个任务的端到端示例见 cookbooks/cookbook.ipynb。
零样本克隆:快速开始 中的 TTS 调用会克隆 prompt_wav_path 的声音。
声音设计:描述声音;无需参考音频。
model.synthesize( task="VOICE_DESIGN", text="冰川在漫长岁月中缓缓移动,也悄悄记录着气候变化的痕迹。", controls={"style": "成熟沉稳的男性纪录片旁白,吐字清晰,节奏舒缓,语气理性而有厚度。"}, use_zero_spk_emb=True, )内置声音:推荐 US_James、US_Stella、灵小柔 和 灵楷。参见 完整声音列表。
model.synthesize( task="IP", text="The garden will remain open until sunset, provided the weather stays clear.", controls={"ip": "US_James"}, use_zero_spk_emb=True, )如何说自由形式:用一条自然语言指令描述声音和表达方式。两个模型默认都在无参考音频的情况下生成;不建议添加参考。不与声音设计、内置声音、情感、方言或属性控制项组合使用。
model.synthesize( task="FREEFORM", text="The old radio crackled softly as the storm moved across the valley.", instruction="Speak in a warm, intimate storytelling voice, with a gentle pace and a hint of nostalgia.", use_zero_spk_emb=True, )对于 Tiny,省略 prompt_wav 和 prompt_text:
tts.generate( task="freeform", text="The old radio crackled softly as the storm moved across the valley.", instruction="Speak in a warm, intimate storytelling voice, with a gentle pace and a hint of nostalgia.", )情感:高兴 / 悲伤 / 愤怒 / 恐惧 / 厌恶 / 惊讶 / 中性。
model.synthesize( task="EMOTION", text="所有测试都顺利通过了,我们终于可以把这个好消息告诉大家!", controls={"emotion": "高兴"}, prompt_wav_path="data/wavs/emotion_prompt.wav", use_spk_emb=True, )语速、音高和音量:语速 慢速 / 中速 / 快速,音高和音量 低 / 中 / 高。
model.synthesize( task="BASIC", text="今晚的观测将在云层散开后开始,请耐心等待下一次通知。", controls={"speed": "慢速", "pitch": "中", "volume": "中"}, spk_emb_path="/path/to/speaker_embedding.pt", use_spk_emb=True, )超越文字副语言标签:可内联,出现在句子任意位置,支持中文或英文。[Breathing]、[Cough]、[Sigh]、[Laughter]、[Surprise-ah]、[Surprise-oh]、[Dissatisfaction-hnn]、[Uhm]、[Confirmation-en]、[Question-ei]、[Question-ah]、[Question-en]、[Question-oh]、[Question-huh]。
model.synthesize( task="TTS", text="[Sigh]雨还是没有停,[Cough]我们恐怕只能把活动改到室内了。", prompt_wav_path="data/voice_presets/voice_audio/lingguang.wav", prompt_text="诶,你今天有空吗?我们能不能聊聊这件事啊?", use_spk_emb=True, )适用场景多语言:五种新语言需要 language_id;短代码和全名均可使用。
model.synthesize( task="MULTILINGUAL", text="週末、駅前の小さな喫茶店で、季節限定の抹茶パフェを食べました", language_id="Japanese", # ja / ko / de / fr / es prompt_wav_path="/path/to/japanese_prompt.wav", prompt_text="参考音频对应的日语文本。", use_spk_emb=True, )方言:chuanyu dialect 或 cantonese;此任务不接受 language_id。
model.synthesize( task="DIALECT", text="今日天气几好,我哋食完饭一齐去海边行下啦。", controls={"dialect": "cantonese"}, prompt_wav_path="data/wavs/yue_prompt.wav", use_spk_emb=True, )内置音色推荐音色 音色 语言 角色 US_James 英语(美国) 男声。旁白、讲解和纪录片。 US_Stella 英语 — 灵小柔 中文 明亮甜美的年轻女声,吐字清晰。适用于助手和客服。 灵楷 中文 温暖浑厚的年轻男声。适用于电台、纪录片和有声书。 提供超过 100 种中文音色和五种英文音色。完整列表(包括情感特定变体)请参见音色目录。
公开基准如下;独立竞技场结果见Artificial Analysis 排行榜。
下文中,tiny 指 Ming-3.0-tts-tiny,0.5b 指 Ming-3.0-tts-0.5b。排名和标记按指标在所列开源模型中计算;Seed-TTS 和 NVbench-GT 为参考行,不参与排名。若历史 Ming-omni-tts 结果优于加粗的 Ming-3.0-tts 数值,将在表下注明,且不声称 SOTA。加粗表示每列最佳值,下划线表示次佳值;并列共享同一标记。其他系统的结果使用其报告的推理设置。
Tiny 在中文和英文上实现了SOTA 说话人相似度。0.5b 在两种语言上的 WER 都更低,并在中文 WER 上排名第 3。
每个开源模型均在其推荐的推理设置下,采用统一的基于 ASR 的 WER/CER 评估协议进行评估。
Tiny 在德语和西班牙语上实现了 SOTA WER,在法语 WER 上排名第 2,在日语 CER 上并列第 2。0.5b 在韩语上更准确;两个模型的说话人相似度仍有差距。
报告 CER、PCER(副语言 CER)和 OCER。NVbench-GT 为人工标注的参考结果,仅用于提供背景,不参与排名。
两个模型共同在全部六项中英文单标签指标上实现了 SOTA;tiny 还在全部三项英文多标签指标上领先。中文多标签控制仍落后于 NV-CV3。
Tiny 在四川话控制准确度上更强,实现了SOTA 四川话 Hard CER 和 Easy ACC,而 0.5b 实现了SOTA 粤语 Base CER 和 ACC。粤语说话人相似度仍低于 CosyVoice2-Yue。历史 Ming-omni-tts 结果在四川话 Easy CER(2.25%)、Hard SIM(0.750)和 Hard ACC(90.45%)以及粤语 Coverage CER(7.87%)上仍然更强。
Tiny 和 0.5b 在平均 ACC 上分别排名第 2和第 3。Tiny 在文本相关的开心和悲伤上更强,而 0.5b 在愤怒上更强;文本无关情感仍是两者的共同局限。历史 Ming-omni-tts 结果在文本相关悲伤(86%)和文本无关愤怒(82%)上仍然更高。
0.5b 和 tiny 在平均 ACC 上分别排名第 2和第 3。Tiny 在两个悲伤子集上均实现了 SOTA,而 0.5b 的整体准确率更高。历史 Ming-omni-tts 结果在文本相关开心(78%)和文本无关开心(30%)上仍然更高。
Tiny 和 0.5b 在平均 ACC 上分别排名第 2和第 3,落后于 Qwen3-TTS。角色扮演指令遵循仍是两个模型的主要差距。
0.5b 的控制精度更高,而 tiny 的 WER 更低、说话人相似度更高。历史 Ming-omni-tts 模型在平均 ACC、音高、WER 和 SIM 上保留了整体记录。
Tiny 在 CER 上排名第 1,在 cpSIM 和 UTMOS 上排名第 2。历史 Ming-omni-tts 保持了更低的 CER 和更高的 UTMOS。
依据 MIT 许可证发布。
来源:蚂蚁 inclusionAI:GitHub 新仓库 · github.com
配图