AI News
AWS 发布 TorchNeuron:Trainium 的原生 PyTorch 后端
Introducing TorchNeuron: Native PyTorch backend for AWS Trainium
AWS 发布 TorchNeuron,一个面向 AWS Trainium 的开源原生 PyTorch 后端,将于 10 月 20 日在 PyTorch Conference North America 上以 Apache 2.0 协议开放公开 Beta,代码位于 github.com/aws-neuron/torch-neuronx。
AWS 团队官方发布 Trainium 的原生 PyTorch 后端,说明 API 兼容路径、执行模式与开源计划,读者可据此评估迁移成本。
另外 2 家也报道了正文 · AI 翻译中文原文前沿模型涵盖语言、视频和音频,架构从稠密和混合专家 Transformer 到扩散、状态空间、世界和结构预测模型。PyTorch 是 AI 研究发生的地方,是定义模型的地方,也日益成为生产运行的地方。研究人员希望进行实验和创新,客户则希望获得 AWS Trainium 提供的性能,以实现其性能和规模目标。训练和推理库是针对 PyTorch 自身的 API 编写的,新的库和新版本持续发布。过去几年中,PyTorch 使这些 API 与加速器无关,并提供了用于注册自定义硬件的官方扩展点。
今天,为满足开发者和研究社区对 Trainium 日益增长的需求,我们很高兴在 10 月 20 日于北美 PyTorch Conference 开源发布之前,分享一种更简单的方法,将芯片作为标准 PyTorch 设备进行编程。AWS Trainium 是一系列 AI 芯片,专为下一代云规模 AI 训练和推理从头设计。我们宣布推出 TorchNeuron,这是一个面向 Trainium 的开源原生 PyTorch 后端,使模型代码、库以及你已在使用的工具都能在 Trainium 上运行。这一集成直接建立在 PyTorch 社区创建的加速器无关扩展点之上,包括 PrivateUse1 设备后端和 torch.accelerator API。
TorchNeuron 在 Trainium2 和 Trainium3 上支持用于研究和调试的 eager 执行(包括性能改进的全新自适应 eager 模式)、用于生产性能的 torch.compile,以及用于自定义内核的 Neuron Kernel Interface (NKI)。此外,借助 Neuron Explorer,性能工程师可以使用相同的 torch.profiler 追踪从框架到硬件的执行过程,将每个事件链接回其源代码行,从而精确定位瓶颈并高效优化。TorchNeuron 将以 Apache 2.0 许可证在 github.com/aws-neuron/torch-neuronx 开源发布,并于 10 月 20 日作为公开 Beta 版上线。
“PyTorch 的愿景很明确:开发者应在不同硬件平台上获得一致的体验。对 AWS Trainium 的原生支持扩展了这一选择,使研究人员和工程师能够使用他们已熟悉的 eager 执行和分布式 API 进行实验和迭代。团队可以利用 Trainium 的能力,而无需重新构建工作流或离开 PyTorch 生态系统。”——Meta PyTorch 工程总监 Jana van Greunen
快速开始非常简单。使用指针在 Trainium 上运行你的代码:.to('neuron')。
# Run a training loop on Trainium model = MyModel().to('neuron') # the only change optimizer = torch.optim.AdamW(model.parameters()) for batch in dataloader: optimizer.zero_grad() loss = criterion(model(batch), targets) loss.backward() optimizer.step() 针对 PyTorch 推荐的设备无关 API torch.accelerator 编写的现代代码无需修改即可运行。编译模型需要指定一次 Neuron 后端,使用 torch.compiler.set_default_backend("neuron"),之后由 torch.compile(model) 接管,或按调用使用 torch.compile(model, backend="neuron")。
# Run a compiled training loop on Trainium torch.compiler.set_default_backend("neuron") # call once, before any compile model = MyModel().to('neuron') model.compile() # no backend argument optimizer = torch.optim.AdamW(model.parameters()) for batch in dataloader: optimizer.zero_grad() loss = criterion(model(batch), targets) loss.backward() optimizer.step() 功能TorchNeuron 通过 PrivateUse1(PyTorch 用于自定义硬件的官方扩展点)注册 Trainium,因此标准 API 可按原样工作:torch.nn、torch.tensor、torch.autocast、torch.distributed 和 torch.profiler 均在 neuron 设备上运行。PyTorch 的两种执行模式 eager 和 torch.compile 均可原生工作。
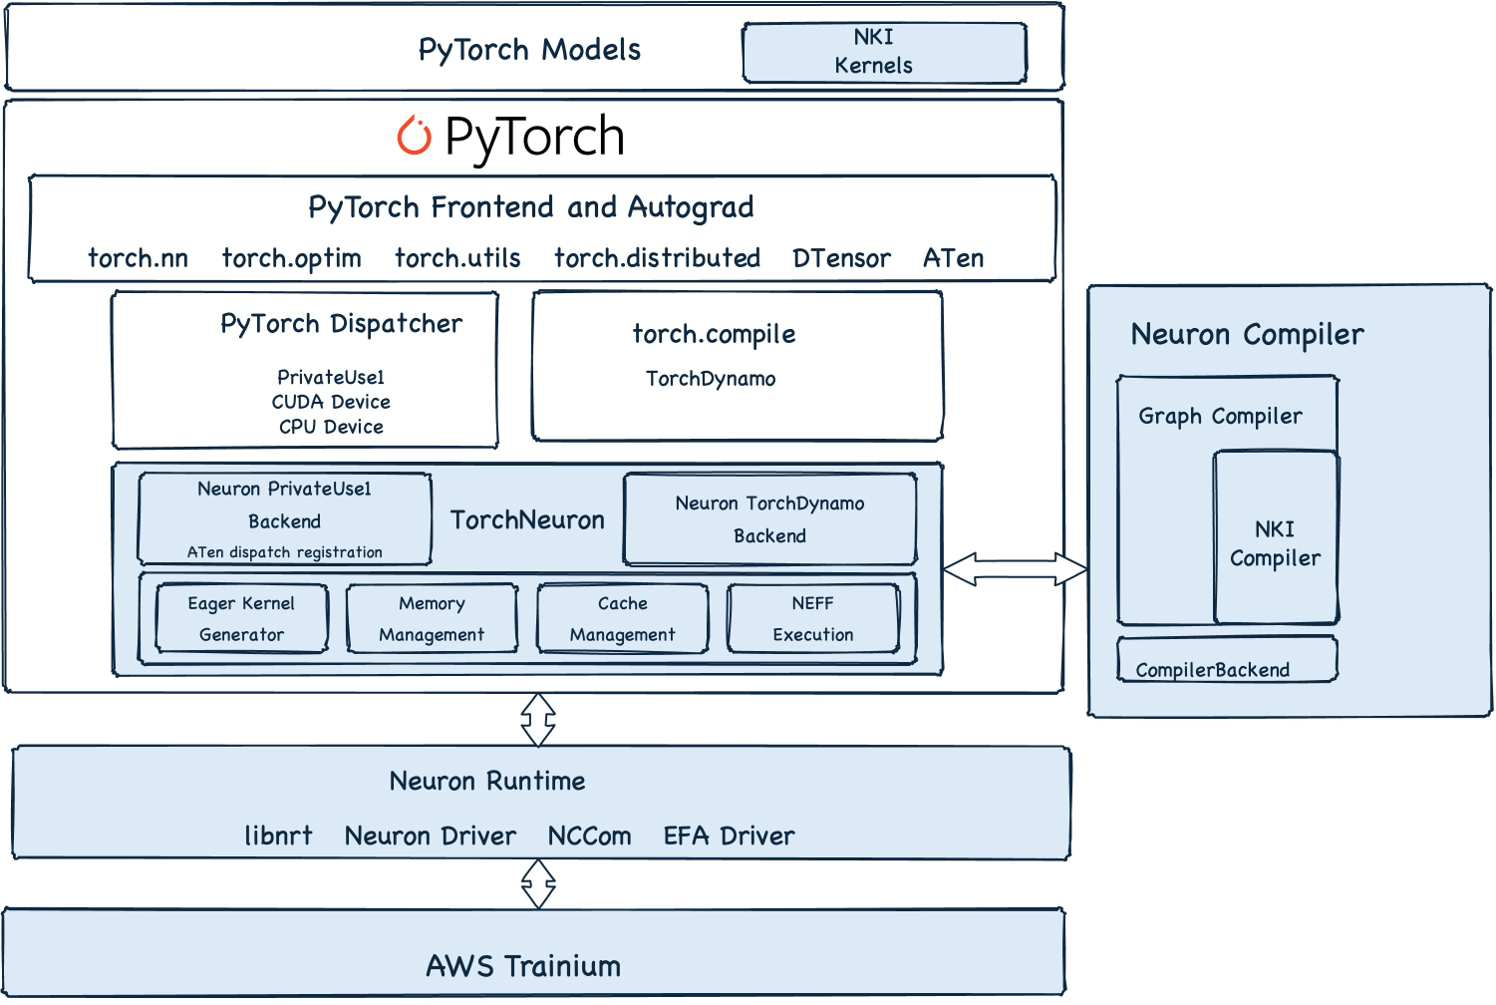
TorchNeuron 的高层架构图(详情)。
Eager 模式会立即执行操作,因此 Python 控制流、打印和断点都能正常工作,无需编译或跟踪步骤。这是用于研究和调试的模式。Eager 模式会逐个分派操作。每个操作直接执行时都会编译自己的 Neuron 可执行文件格式(NEFF)文件,在设备上启动它,并通过 HBM 移动其中间结果。我们还引入了自适应 eager 模式(实验性),以降低启动开销,并提供更好的操作融合机会,在不修改代码的情况下接近编译图的性能,同时保留交互式体验。
torch.compile(model, backend="neuron") 将模型捕获为图,由 Neuron 编译器进行优化,是用于稳定、高性能模型投入生产的模式。torch.compile 可用于优化整个模型或部分模型,并与 eager 模式无缝协作。原生支持 FlexAttention。TorchDynamo 将模型捕获为 FX 图,AOTAutograd 提前跟踪反向图,Neuron 后端通过 Torch-MLIR 将结果降为 StableHLO,Neuron 编译器生成在硬件上执行的 NEFF 文件。
Neuron 推理栈基于 TorchNeuron 中相同的 torch.compile 支持构建。vLLM Neuron 是 vLLM 的插件,用于服务 LLM;vLLM Omni Neuron 是 vLLM Omni 的插件,用于服务图像和视频生成的扩散模型。
广泛覆盖 aten 算子,涵盖文本、多模态与视觉语言、图像与视频生成和理解、状态空间模型以及世界模型中出现的算子。模型可以使用 BF16、FP32 和 FP16,以及整数和布尔类型,torch.autocast 和混合精度代码按原样运行。TorchAO 和 FP8 目前处于私有 Beta 阶段,将在下一版本中正式可用。
分布式推理和训练可以使用标准 PyTorch API,高级并行模块可按原样与你的模型组合:DDP、FSDP2、SimpleFSDP、张量并行和流水线并行,以及 FSDP2 与张量并行、ZeRO 等常见组合,这些对训练大型模型至关重要。支持 DTensor 和 DeviceMesh 来处理分片和多维进程组。支持集合通信 API(例如:all_gather、reduce_scatter、all_reduce)和 P2P API(send、recv)。集合通信在节点内通过 Trainium 专用的集合通信核心执行,在节点间通过 Elastic Fabric Adapter(EFA)执行,因此通信传输原生适配硬件,无需更改 PyTorch API。
Torch 流和事件原生受支持。torch_neuronx.Stream 和 torch_neuronx.Event 将 PyTorch 的流语义映射到 Trainium 的硬件队列上。在同一个流内,数据移动和计算会自动保持顺序。不同的流之间没有隐式依赖关系,因此跨流时,你需要通过在生产者流上记录事件,并在消费者流上等待该事件,然后再使用结果,来显式地建立这种顺序。与设备无关的 torch.Stream、torch.Event 和 torch.accelerator 入口点会到达相同的实现,因此针对它们编写的代码无需修改即可运行。错误会在下一个同步点暴露,而不是在导致该错误的操作处暴露;TorchNeuron 会跟踪最早的异常,并在该同步点以原始上下文重新抛出它。在执行时,非默认流会多路复用到单个硬件队列上,因此它们会保留顺序、优先级和事件语义,但不会各自获得专用引擎;并且当主机集合通信被禁用时,在非默认流上发出的集合通信会保留其在该流执行顺序中的位置,但会在默认硬件队列上运行。
Neuron 内核接口(NKI)让研究人员和开发者能够为 eager 和 torch.compile 开发、优化并执行自定义算子。研究人员可以针对需要底层硬件控制的想法进行原型验证,包括新的模型架构。开发者可以通过在模型代码中直接调用性能关键的 NKI 内核来替代一系列标准 PyTorch 操作(ATen 操作),从而获得超越 Adaptive Eager 和 torch.compile 的更精细的性能控制。
TorchNeuron 还提供由 NKI 实现、针对 Trainium 优化的高性能算子,并以开源形式发布为 NKI-lib,覆盖稠密模型和 MoE 模型的主流 LLM 与多模态场景,例如 FlashAttention 和 MoE blockwise 内核,开发者可以使用它们来提升在 Trainium 上的性能。以下示例使用 PyTorch 推荐的 register_autograd 风格定义并注册了一个自定义 NKI 算子:
import torch import nki import nki.language as nl from torch_neuronx import nki_op # Declaring and implementing NKI kernels # Note in NKI kernels, the output tensor should be defined as parameter to the kernel @nki.jit def sin_kernel(in_ptr0, out_ptr): input_tile = nl.load(in_ptr0[0:128]) output_tile = nl.sin(input_tile) nl.store(out_ptr[0:128], value=output_tile) return out_ptr # defining cos since it will be used in backward path of sin @nki.jit def cos_kernel(in_ptr0, out_ptr): input_tile = nl.load(in_ptr0[0:128]) output_tile = nl.cos(input_tile) nl.store(out_ptr[0:128], value=output_tile) return out_ptr # after this line, there is no NKI code, just native PyTorch, registering custom ops @nki_op("mylib::pt_nki_sin", mutates_args={}) def pt_nki_sin(x: torch.Tensor) -> torch.Tensor: out = torch.empty_like(x) sin_kernel(x, out) return out @nki_op("mylib::pt_nki_cos", mutates_args={}) def pt_nki_cos(x: torch.Tensor) -> torch.Tensor: out = torch.empty_like(x) cos_kernel(x, out) return out def pt_nki_sin_backward(ctx, grad): x, = ctx.saved_tensors return grad * pt_nki_cos(x) # cos is derivative of sin def pt_sin_setup_context(ctx, inputs, output): x, = inputs ctx.save_for_backward(x) # Register backward pass and context function used during autograd for nki_sin pt_nki_sin.register_autograd(pt_nki_sin_backward, setup_context=pt_sin_setup_context) if __name__ == "__main__": x = torch.randn(128, 1, device="neuron", requires_grad=True) # Forward pass uses sin_kernel y = pt_nki_sin(x) # Backward pass, autograd calls uses nki_sin_backward() -> cos_kernel() loss = y.sum() loss.backward() 使用 TorchNeuron 进行性能分析TorchNeuron 与标准 torch.profiler.profile API 集成,并扩展了一个 NeuronConfig 对象,用于控制 Neuron 特定的数据收集。这使用户能够捕获并关联来自框架级 CPU 操作(PyTorch 调度、Python 栈)以及 Neuron 运行时和 Trainium 活动的跟踪数据(由 NeuronConfig 控制),从而实现端到端性能分析。
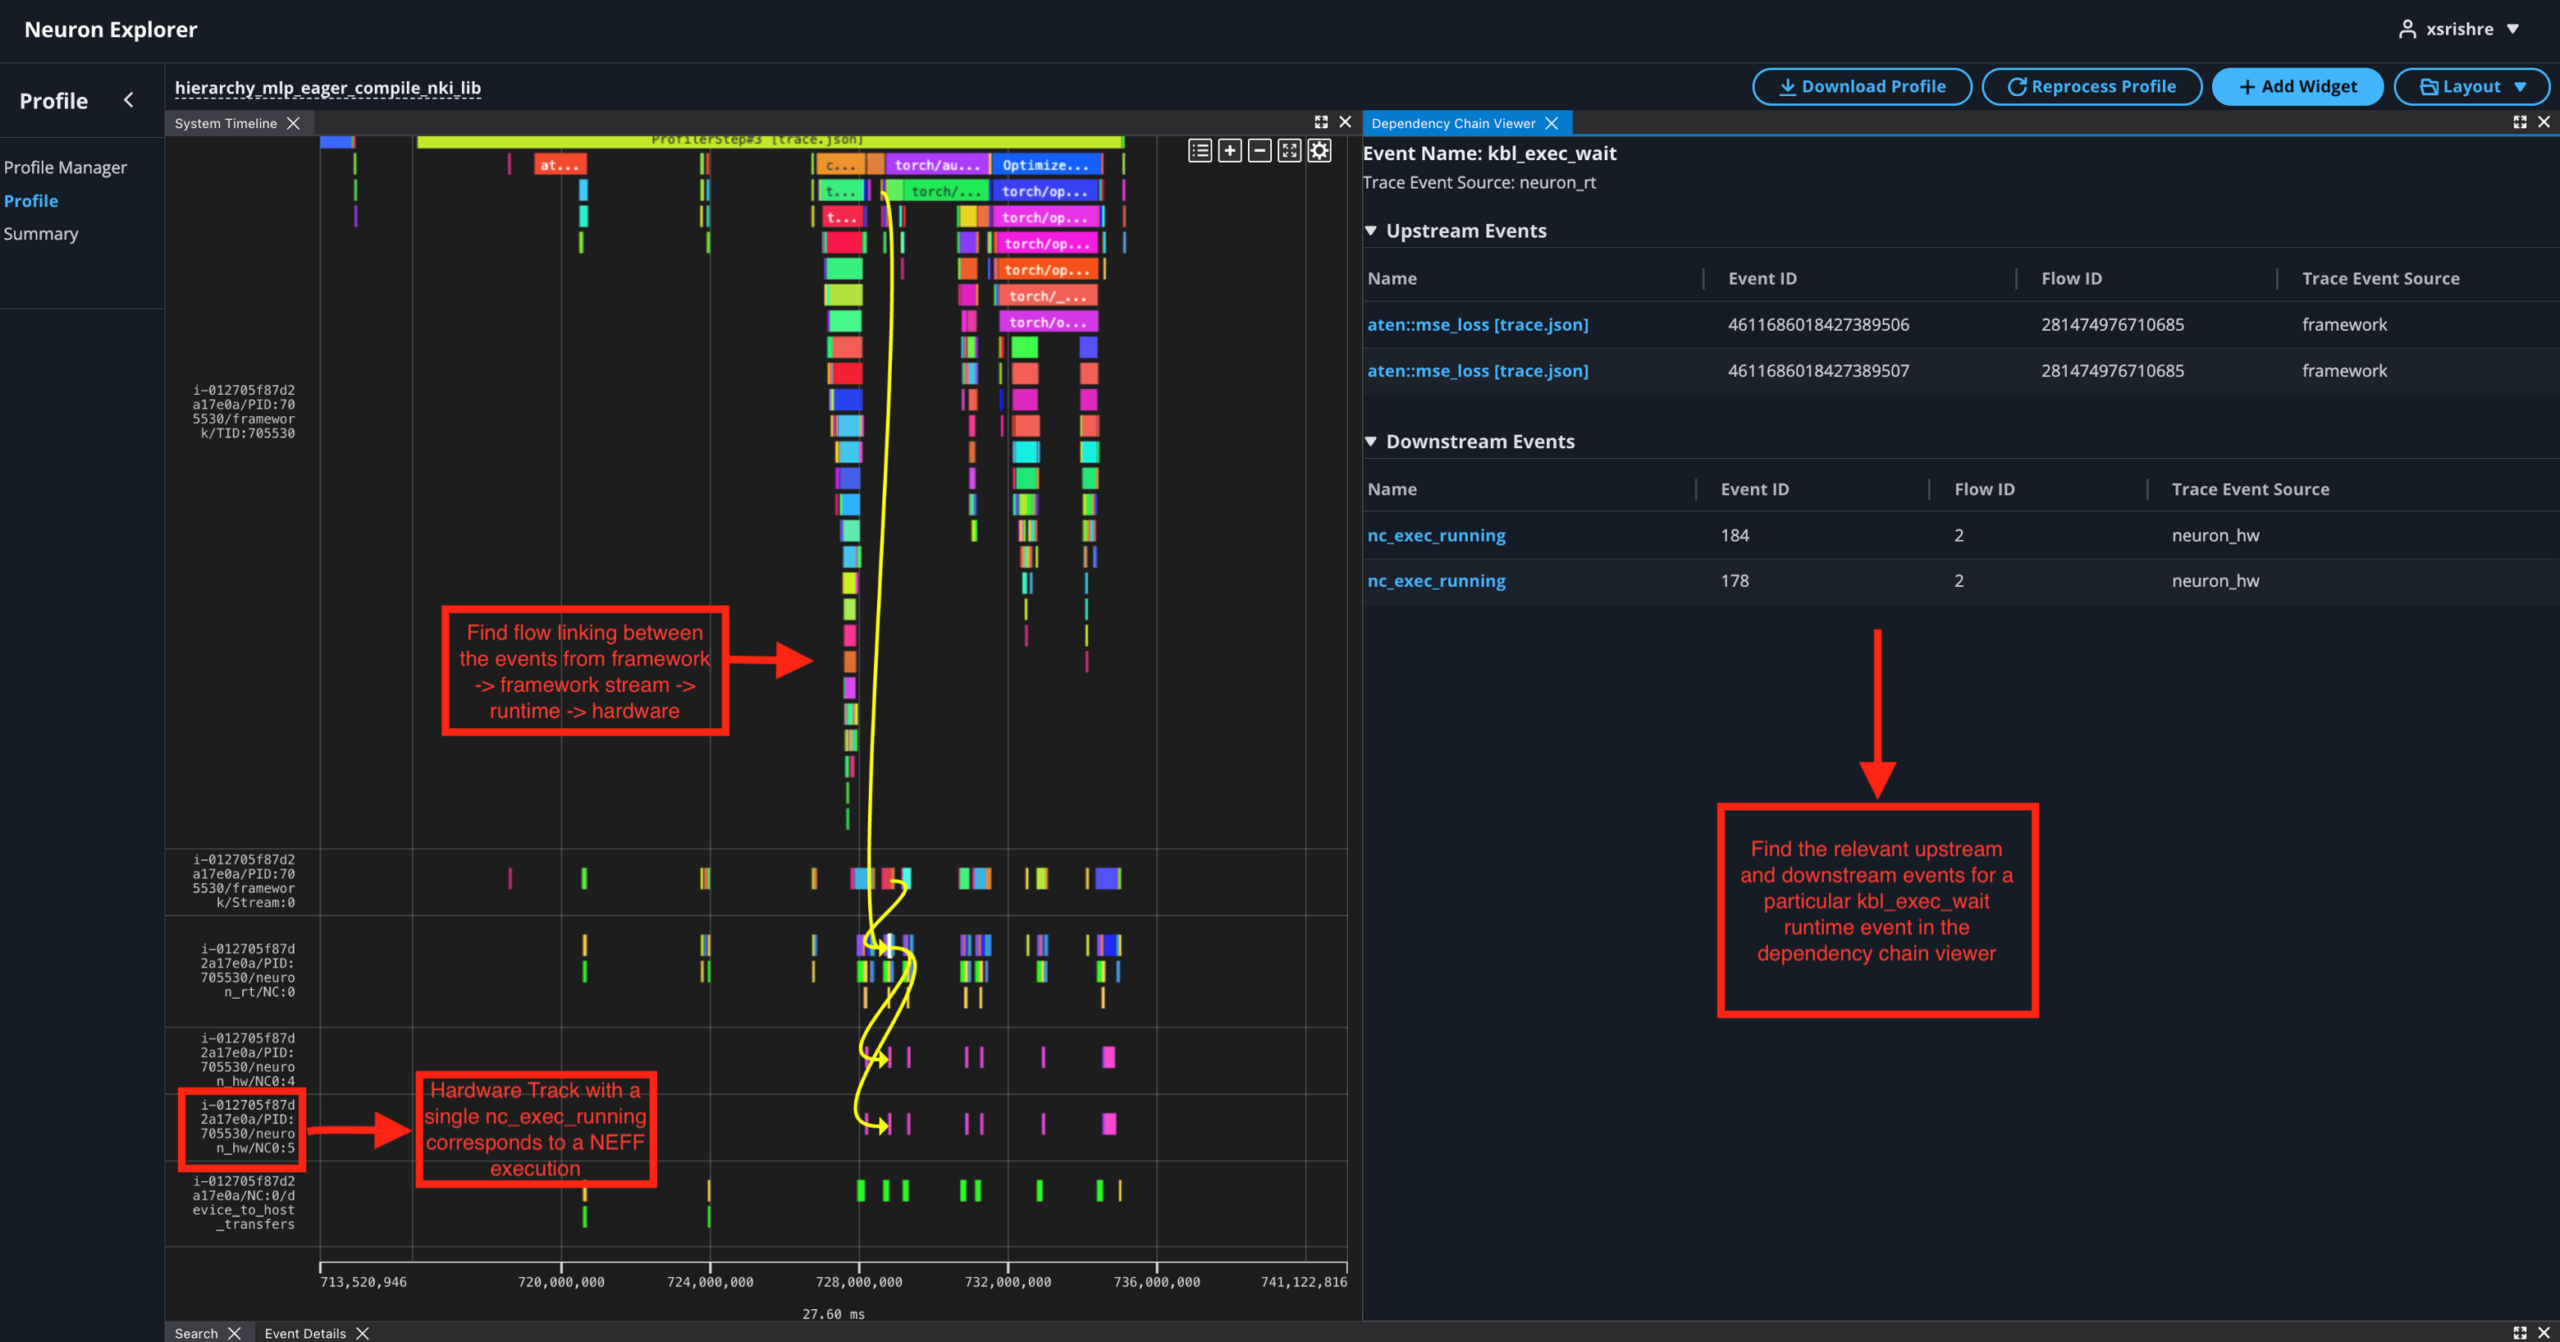
捕获的性能分析数据可以在 Neuron Explorer UI 中可视化,用户可以跨框架、运行时和设备跟踪执行过程,从任意事件跳转到确切的源代码行(源代码查看器),通过调用层级浏览工作负载(层级查看器),并沿着依赖链查看每个停顿在等待什么(依赖链查看器)。
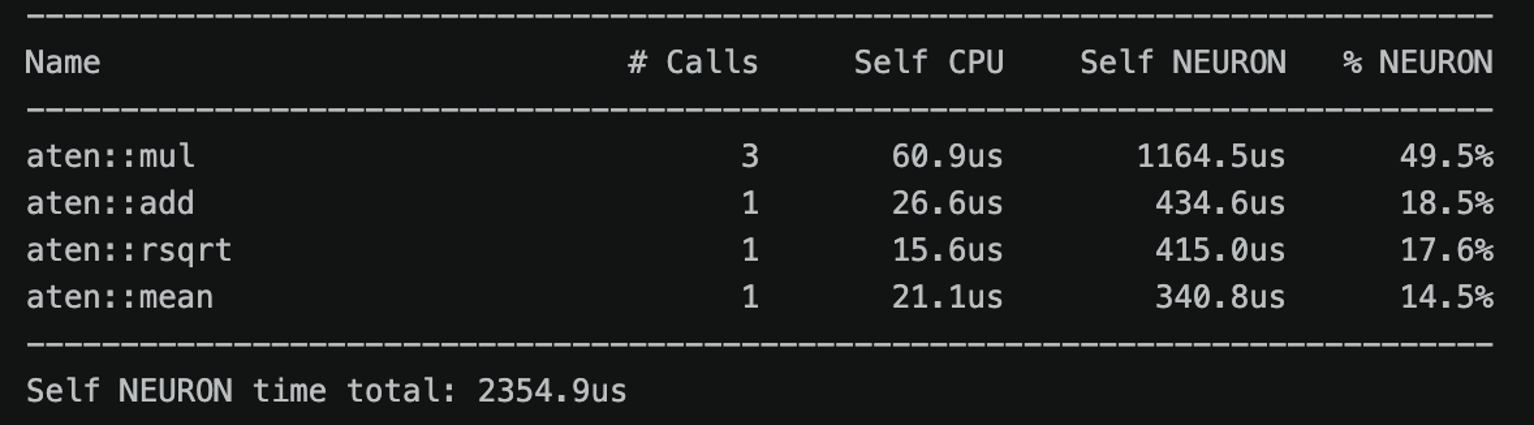
Neuron Explorer 还会输出一个 Parquet 输出,其中包含每个算子和每个引擎的指标,因此 UI 背后的同一份数据可以直接查询,或由代理用于自动化瓶颈分析。对于程序化访问,用户可以使用内置的 torch.profiler 工具。例如,key_averages 表让用户可以深入查看特定算子,并使用 sort_by 参数显示每个算子的设备侧开销,这对于识别热点很有用。
以下代码片段展示了一个示例(详情):
import torch from torch.profiler import profile, ProfilerActivity from torch_neuronx.profiling import NeuronConfig, ProfileMode, NeuronProfiler # Configure Neuron profiling and pass appropriate path as OUTPUT_DIR nc = NeuronConfig( modes=[ProfileMode.DEVICE, ProfileMode.RUNTIME], profile_output_dir=OUTPUT_DIR, capture_enabled_for_nc='0', correlate_device_time=True, ) # NeuronProfiler.export_trace() places the framework trace # in the same directory as Neuron system traces exporter = NeuronProfiler(nc) device = torch.device('neuron') x = torch.randn(4, 512, dtype=torch.bfloat16, device=device) weight = torch.ones(512, dtype=torch.bfloat16, device=device) def rms_norm_fn(t): x_sq = t * t mean_sq = x_sq.mean(dim=-1, keepdim=True) rms = torch.rsqrt(mean_sq + 1e-6) return t * rms * weight # Profile your workload with torch.profiler.profile( activities=[ProfilerActivity.CPU, ProfilerActivity.PrivateUse1], experimental_config=nc, record_shapes=False, on_trace_ready=exporter.export_trace, schedule=torch.profiler.schedule(wait=2, warmup=1, active=1), ) as prof: for step in range(4): with torch.no_grad(): _ = rms_norm_fn(x) torch.neuron.synchronize() prof.step() # Print the per-op summary, sorted by device time to surface hotspots print(prof.key_averages().table(sort_by="self_privateuse1_time_total", row_limit=4))
有关更多能力和功能,请参阅 Neuron Explorer 文档。
TorchNeuron 已被初创公司、企业、机器学习行业合作伙伴和学术机构广泛采用:涵盖自动驾驶、机器人、视频生成、语音、电信、医疗健康和地理空间建模。以下是各团队当前构建成果的概览。
“Cartesia 正在构建能够像人类一样从世界中学习并与之交互的智能,起点是对话。我们在 Mamba 等状态空间架构上的开创性工作支撑了 Sonic(文本转语音)和 Ink(语音转文本),这些语音 AI 模型驱动着真正像人类一样的对话体验。真实对话同时需要三样东西:质量(自然度和准确度)、效率(大规模下的低延迟)和可控性。大多数解决方案只能提供其中一两个。我们从第一性原理出发设计研究和产品,以同时实现这三点,这意味着我们需要能够在不重写技术栈的情况下,从每一层榨取最大性能的基础设施。借助 AWS Trainium 上的 PyTorch 原生支持,我们以对 PyTorch 代码的最小改动运行了标准推理流水线。小而快的算子通过原生路径高效映射,因此我们无需为它们手写内核。这让我们团队能够专注于为被反复调用、决定端到端延迟的层编写高性能 NKI 内核。对于实时语音,每一毫秒的网络距离都至关重要。在 Trainium 上运行有助于将 Sonic 和 Ink 部署到全球客户附近。”
Arjun Desai,Cartesia 联合创始人
“语音正在成为 AI 的一等模态,Deepgram 每年为超过 200,000 名开发者和 1,400 家组织处理数千万亿的音频 token。为满足这一需求,我们需要高效扩展,同时持续交付更好的模型。在为期数月的合作中,AWS 生成式 AI 创新中心帮助我们将其模型移植到 AWS Trainium 上的 PyTorch 原生支持。在我们评估的基准测试中,Trainium 每美元处理的输入音频秒数比我们现有的 GPU 基线多约 60%,这有助于我们以更低价格向客户提供更好的模型。我们期待在解决方案中支持未来的 AWS AI 芯片。”
Adam Sypniewski,Deepgram CTO
“Hugging Face 是领先的 AI 构建者开放平台,通过 Transformers 和 Diffusers 等由 PyTorch 驱动的开源库,免费提供对超过 600 万个开放模型、数据集和应用的访问。此前,要利用 AWS Trainium 需要用 Neuron 专用软件和配置来适配 Hugging Face 模型;TorchNeuron 使 Trainium 成为 Transformers 和 Diffusers 的原生后端,因此开发者可以通过完全开源的栈使用熟悉的模型定义——这切实体现了我们对芯片中立性和兼容性的承诺。现在,在 AWS Trainium 上部署最先进的开放 LLM 以及最新的开放图像和视频生成模型比以往任何时候都更容易,TRL 支持微调和强化学习,Neuron 内核通过我们的库自动提供优化性能。”
Jeff Boudier,Hugging Face 产品副总裁
在这些客户之外,我们还一直在与众多合作伙伴合作,他们正在基于 TorchNeuron 进行构建,以增强 Trainium 生态系统。这些合作伙伴包括 Anyscale、Decart、Kernelize、Loka、Luminal、Makora、Modular、Nota AI、Radix、Wafer 和 Yasp。
我们对原生 PyTorch 支持的目标之一,是让开发者能够利用 Trainium 的性能和成本优势,同时继续使用他们已经熟悉的模型、库和工作流。这有助于保护他们在 PyTorch 上的投资,包括其模型代码、推理和训练基础设施、调试实践,以及他们所依赖的社区项目。
运行 AI 工作负载的成本包括使其正常工作、优化其性能,以及随着模型和库的演进而维护它们所需的工程时间。我们希望开发者花更多时间试验架构和改进模型质量,减少将软件适配底层硬件的时间。他们应当能够从熟悉的模型或训练配方开始,将其适配到自己的工作负载,并在 Trainium 上运行,只需做极少的 Neuron 特定改动。
TorchNeuron 通过与更广泛的 PyTorch 兼容,为这一体验提供了基础。开发者可以使用 TorchTitan 等库——它汇集了 PyTorch 的分布式和编译能力以支持大规模训练——以及 Hugging Face Transformers,后者提供对社区模型实现、预训练检查点以及用于将模型适配到其应用的 API 的访问。
TorchTitan 是 PyTorch 用于快速实验和大规模训练的原生库。其模块化设计使自定义训练、测试新想法和扩展实验变得更加容易。TorchTitan 目前已在 Trainium 上训练。我们持续向上游贡献到主线 TorchTitan,torchtitan-neuron 会在这些改进合并之前提供给你,并在每项改进落地时与主线保持一致。Trainium 特定的产物也随 torchtitan-neuron 发布,并通过 TorchTitan 自身的扩展点注册;这些包括 NKI 内核、为 Trainium 调优的模型配置和训练配方,以及 Neuron Explorer 的性能分析集成。
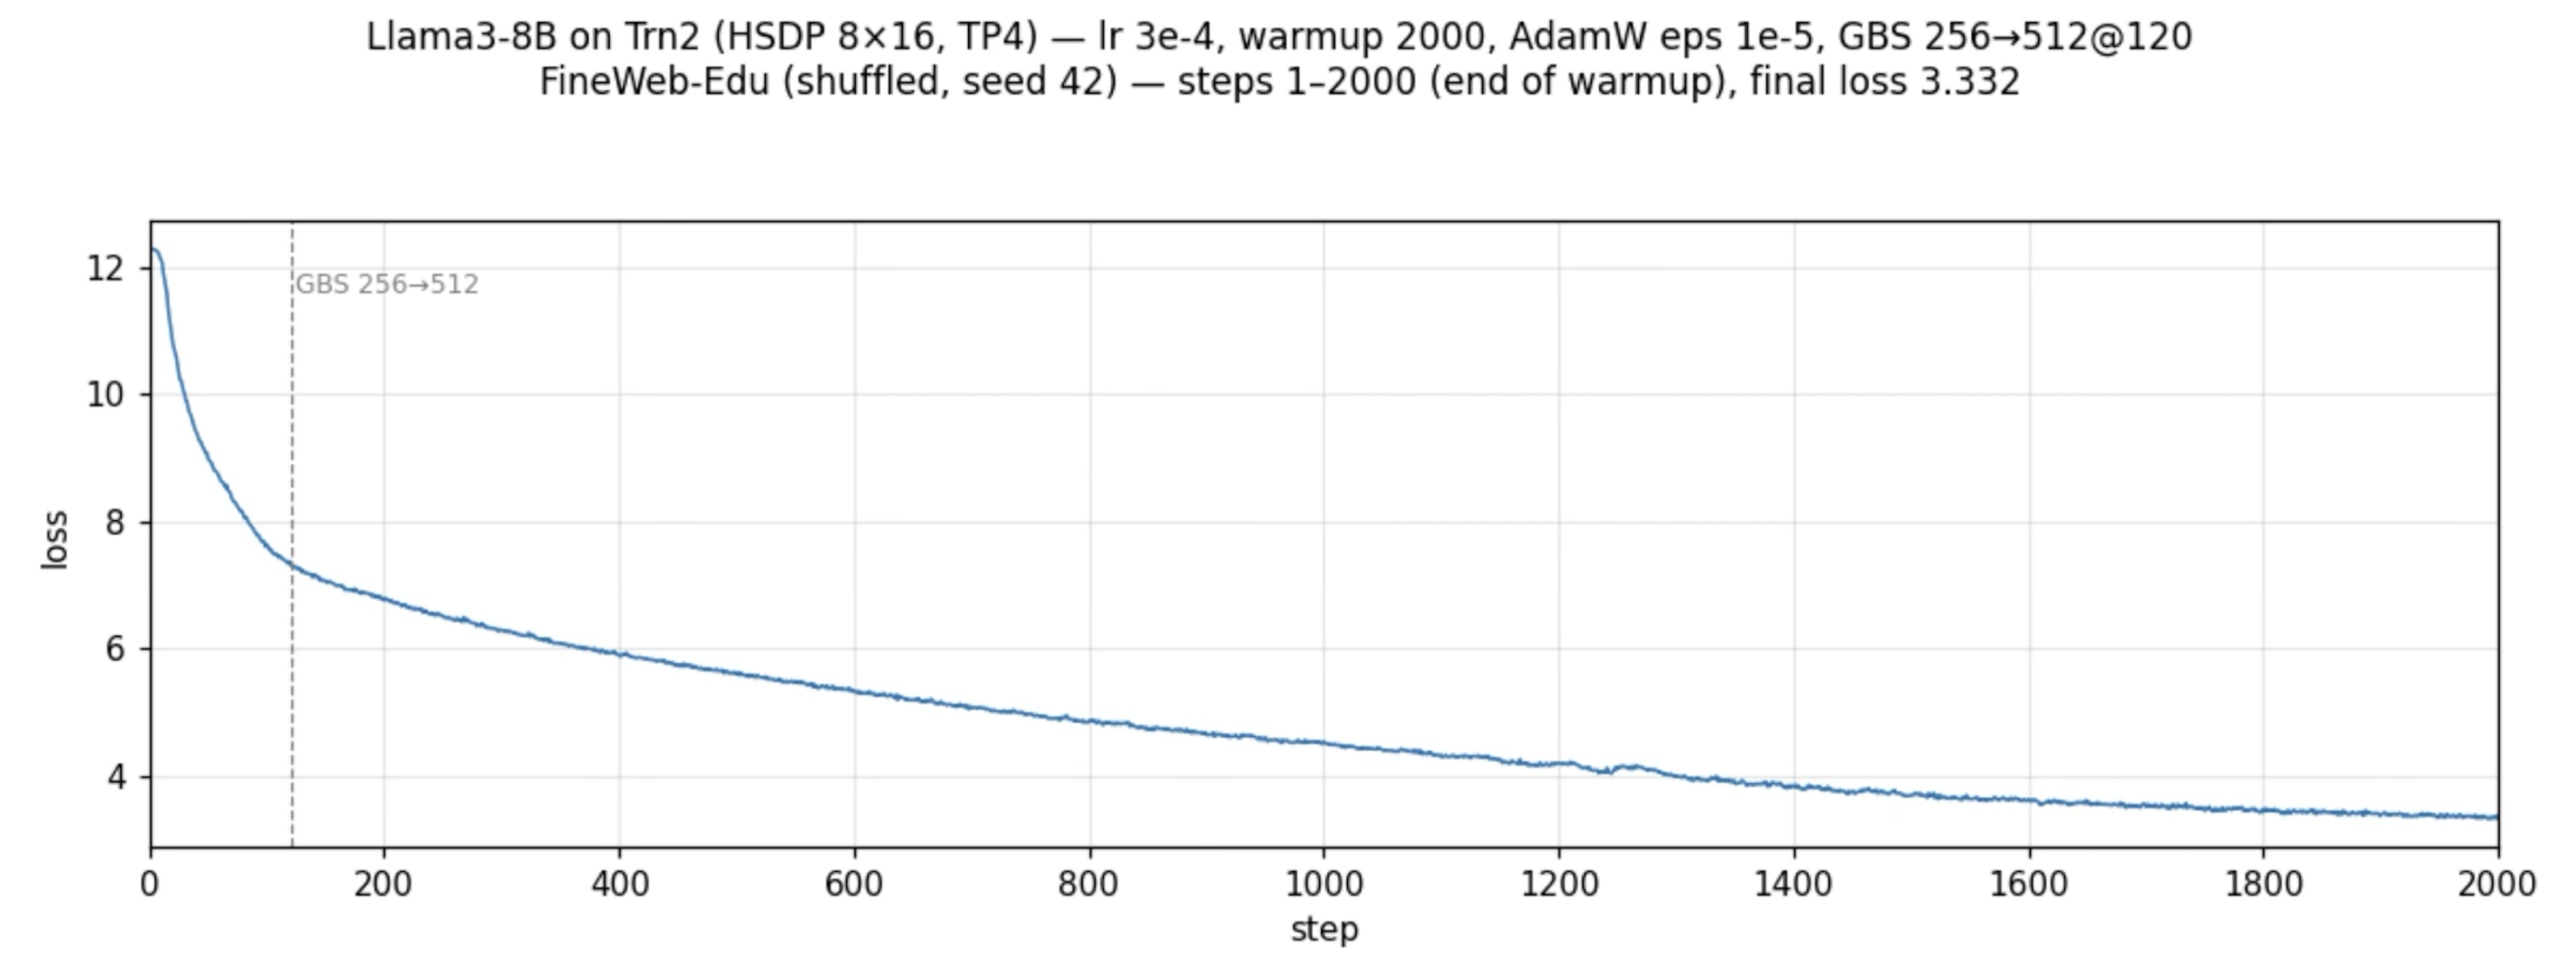
# Install from source git clone https://github.com/aws-neuron/torchtitan-neuron cd torchtitan pip install -r requirements.txt # Download the llama3-8B tokenizer python scripts/download_hf_assets.py --repo_id meta-llama/Llama-3.1-8B --assets tokenizer --hf_token=... # Train Llama3-8B with Simple FSDP + torch.compile on a single trn2.48xlarge instance: export NEURON_RT_NUM_CORES=64 torchrun --nnodes 1 --nproc_per_node $NEURON_RT_NUM_CORES \ --local-ranks-filter 0 --role rank --tee 3 \ --rdzv_backend c10d --rdzv_endpoint "localhost:0" \ -m torchtitan.train --module torchtitan_neuron.experiments.graph_trainer.llama3 --config simple_fsdp_llama3_8b \ --parallelism.tensor-parallel-degree 4 \ --parallelism.data-parallel-shard-degree -1 \ --training.global-batch-size 16 \ --training.local-batch-size 1 \ --compile.enable --compile.backend neuron 以下是使用 TorchTitan 在 8 台 trn2.48xlarge 上以张量并行(TP)和混合分片数据并行(HSDP)训练 Llama 3 8B 的示例损失曲线
Transformers v5 为互操作性而构建:一个模型实现可在任何平台和任何硬件上运行,并可直接被下游训练和服务栈使用。
Trainium 是 Hugging Face 库上游支持的设备,包括 Transformers、Diffusers、trl 和 kernels。Transformers v5 支持文本和音频模型的训练与推理,Diffusers 支持图像和视频生成,trl 支持大型语言模型的强化学习,NKI 内核可通过 Hugging Face kernels 库获得。AWS 和 Hugging Face 为每个库添加了支持,因此现有的 Hugging Face 工作流可在 Trainium 上运行,无需设备特定代码。
from transformers import AutoModelForCausalLM model = AutoModelForCausalLM.from_pretrained( "Qwen/Qwen3-0.6B", # Neuron hardware is automatically detected device_map="neuron" ) TorchNeuron 通过 PyTorch 的 PrivateUse1 扩展点注册 Trainium,从而将 Neuron 纳入 PyTorch 的设备枚举。device_map=”auto” 无需配置即可找到它,device_map=”neuron” 则显式指定它。无论哪种方式,权重都会加载到设备上用于训练或推理,脚本的其余部分保持不变。
我们的测试方法包括在 HuggingFace 和 TorchTitan 模型的广泛覆盖范围内验证 TorchNeuron,以及在 eager 和 torch.compile 两种模式下运行 PyTorch 上游测试套件。
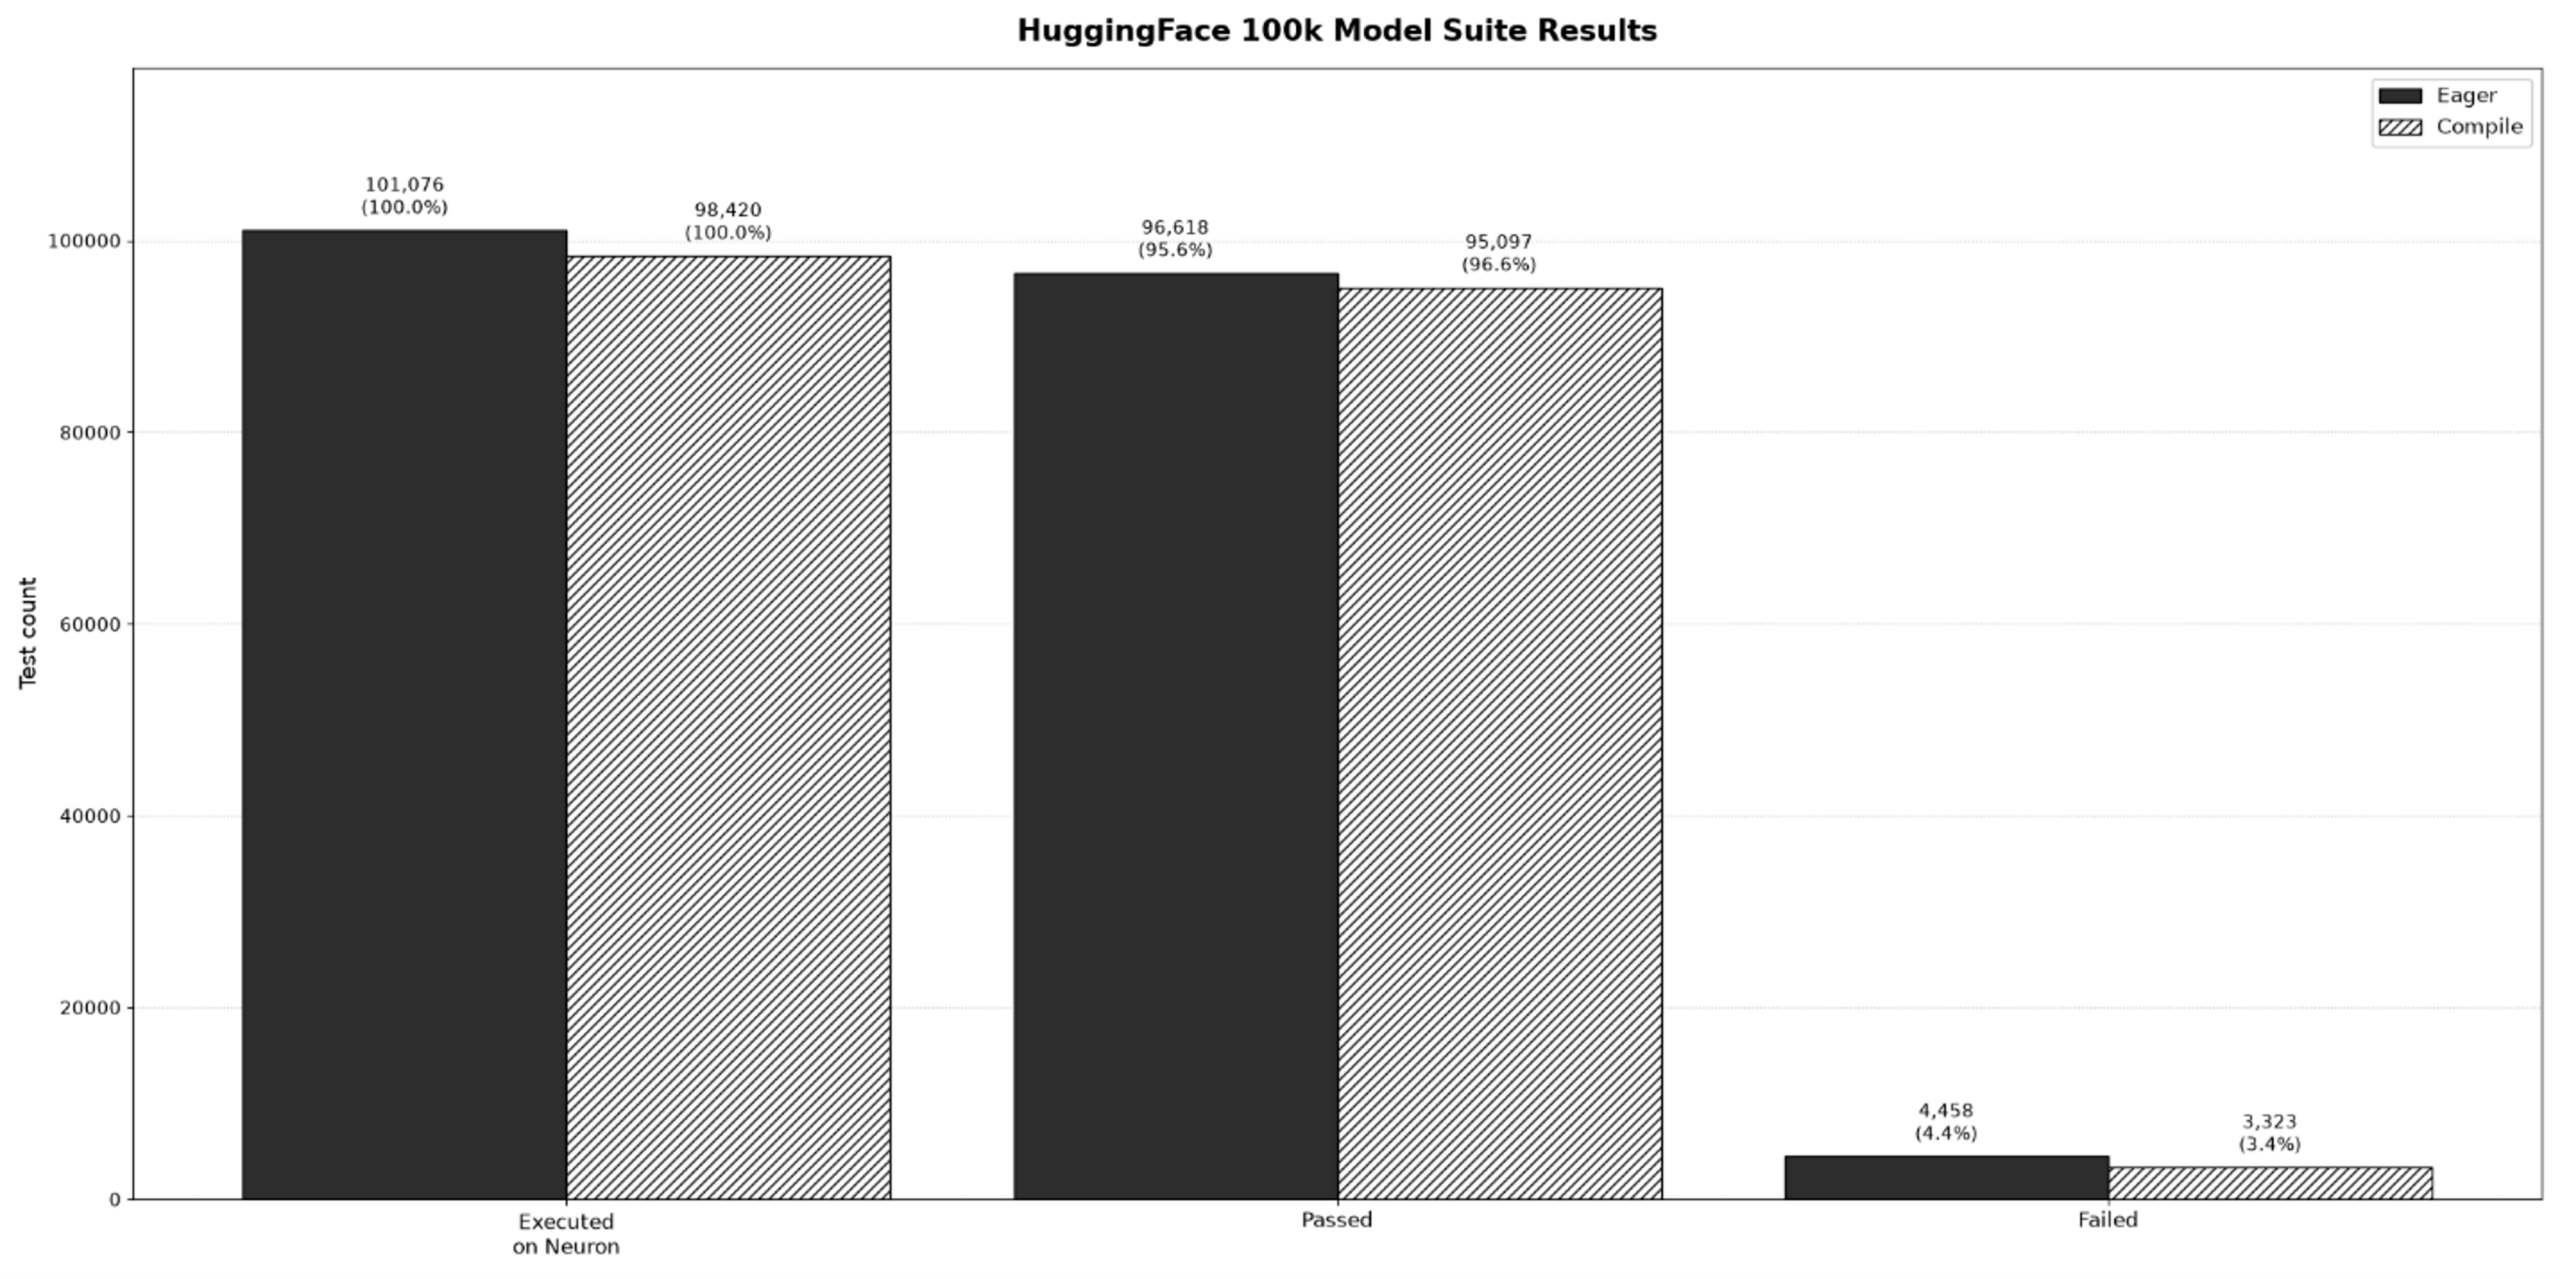
盲扫(大规模广泛测试)。 我们利用 Hugging Face 模型宇宙对开源模型进行广泛扫描。我们持续运行 10 万个 Hugging Face 模型,覆盖 99.9% 的实际使用场景(基于下载量)。我们在 Trainium 上以缩减但具有代表性的配置运行每个模型,并记录发生的情况:是否加载、前向和反向传播是否运行、是否编译,以及哪些算子在该设备上执行、哪些回退到 CPU。
下图展示了截至 2026 年 9 月,在 eager 和 torch.compile 模式下运行 10 万个模型的结果。我们正在努力缩小剩余差距,目标是在未来版本中缩小大部分(如果不是全部)差距。
我们运行 PyTorch 上游测试套件:ATen、Dynamo、分布式和 profiler,并报告相对于已启用测试的通过率。2026 年 8 月的运行产生了约 15.4 万个测试结果,其中约 6.9 万个因有效原因被跳过:其中约 3 万个被 PyTorch 自身的资格检查跳过(例如仅 CUDA 和仅 CPU 测试),并非 Neuron 特有。其余约 3.9 万个是刻意跳过 Neuron 的,分为三组
作为这一过程的一部分,我们还通过提出多项 RFC 和 PR 来回馈 PyTorch,以提升测试质量并移除硬编码的 CUDA 假设(193439、193441、193442,完整 PR 列表见附录 A)。
从 2026 年 10 月 20 日起,TorchNeuron 将以公开测试版形式提供。研究人员和开发者将能够从 AWS Neuron pip 仓库通过 pip install torch-neuronx 进行安装,详情。
以下资源将于 10 月 20 日上线:
有关入门、执行模式和分布式训练的更多指导,请参阅 TorchNeuron 文档。
我们要感谢 PyTorch 社区和 Meta 的 PyTorch 团队在 PyTorch 可扩展机制方面所做的工作,特别是 PrivateUse1 设备后端和 torch.accelerator API,正是它们使这一集成成为可能。我们还要感谢 PyTorch 基金会在 CI/CD 基础设施方面给予的支持。
AWS 致力于支持 PyTorch 生态系统,为 PyTorch CI/CD 基础设施提供 Trainium 资源,并为开源 PyTorch 项目做出贡献。
特别感谢 Anthropic、Anyscale、Amazon AGI、Amazon Rufus、ByteDance、Cartesia、Clay Foundation、Databricks、Decart、Deepgram、Hugging Face、Karakuri、Lieber Institute for Brain Development、Meta、MIT、Neura Robotics、NinjaTech AI、Nota AI、Odyssey、PDT Partners、poolside、Qube Research and Technologies、RadixArk、Ricoh、Rivian、Salesforce、SemiAnalysis、UC Berkeley、Stanford、CMU、UCLA、Zyphra 以及许多其他机构,感谢他们在塑造 TorchNeuron 的设计与能力方面提供的反馈。
贡献者:Apoorv Gupta、Arash Jamalian、Rui Silva、Peter Sam Raj、Kunind Sahu、Kamran Khan、Shreya Srivastava、Charan Shettyhalli Guruswamy、Alex Hoffman、Abigail Fernandes、Sam Jin
文章 Introducing TorchNeuron: Native PyTorch backend for AWS Trainium 首次发表于 PyTorch。
来源:PyTorch:Blog · pytorch.org
配图